Cómo combinar Qwen y Clef en oMLX para que uno escriba y otro decida
Índice de contenidos
- Puntos clave
- Por qué separar el modelo que escribe del que decide
- Qué necesitas para servir Qwen y Clef en el mismo oMLX
- Cómo se llama a Clef por /v1/systemone
- Cuánto tarda y cuánto acierta cada modelo en un M5 Max
- Qué optimizaciones funcionaron y cuáles no
- Ejemplo 1: triaje de tickets con Clef-flash, Qwen y un revisor
- Ejemplo 2: Clef 27B como juez de respuestas con contexto
- Qué pasa cuando Qwen y Clef trabajan a la vez
- Dificultades con las que me he topado al montar Qwen y Clef en el mismo servidor
- Preguntas frecuentes
- ¿Puedo usar Clef como modelo de chat en oMLX?
- ¿Clef-flash o Clef 27B?
- ¿Cuánta memoria necesito para tener los cuatro modelos cargados?
- Conclusión
- Fuentes
Qwen escribe y Clef decide: desde oMLX 0.7.1.dev1 los dos salen del mismo servidor en tu Mac. Qwen responde por /v1/chat/completions y Clef, el modelo de decisión abierto de Cloudflare construido sobre Qwen, por /v1/systemone: lee un texto una vez y devuelve una elección con su probabilidad, sin generar texto. Lo he medido el 13 de octubre de 2026 en un MacBook M5 Max de 128 GB, con 40 tickets de soporte, un juez de respuestas con contexto y los ajustes que funcionaron y los que no. Todas las latencias incluyen el viaje HTTP por la red local. También tienes la versión en inglés.
Puntos clave
- Clef-flash (9B, 5,86 GB) decidió cada ticket en 111 ms de mediana y acertó 39 de 40 etiquetas; Clef (27B, 15,81 GB) tardó 371 ms y acertó las 40.
- Repartir el trabajo funciona mejor que pedírselo todo a Qwen: Clef-flash clasifica y Qwen 9B escribe, con 39 de 40 etiquetas bien frente a 34 cuando Qwen hacía las dos cosas en un JSON.
- Como juez de un RAG, Clef 27B marcó las 4 respuestas que Qwen 9B se inventó; Clef-flash solo 2.
- Activar Lightning MTP en Qwen 27B subió la generación de 29,3 a 42,7 tokens/s (+46 %). El prefill en el Neural Engine no movió a Clef más allá del ruido.
- Fija (pin) los modelos en memoria: los cuatro ocupan 42,2 GB y así evitas cargas en frío y el error 500 de jundot/omlx#4413.
Por qué separar el modelo que escribe del que decide
Un LLM como Qwen genera texto token a token, y si le pides una etiqueta te devuelve texto que tienes que validar. Un modelo de decisión puntúa las opciones que le das en una sola lectura. Michelle Chen lo resume así en el anuncio de Cloudflare[1]: "The decision step is non-autoregressive, so there’s no intermediate text to generate token by token".
Clef parte de una base Qwen de 27B y Clef-flash de una de 9B, los dos con licencia Apache 2.0. En lugar de una frase recibes un JSON con la opción elegida, la probabilidad de cada alternativa y una confianza. Eso te deja fijar un umbral y mandar a una persona lo dudoso, algo que un texto libre no te da.
La combinación tiene sentido porque cada modelo hace lo que mejor se le da. Clef decide la ruta (etiqueta, urgencia, si hace falta una persona) y Qwen solo escribe cuando la ruta lo pide. Después, Clef vuelve a leer el borrador para decidir si se apoya en lo que el cliente dijo.
Qué necesitas para servir Qwen y Clef en el mismo oMLX
Necesitas oMLX 0.7.1.dev1 o posterior en un Mac con Apple Silicon. Si no lo conoces, empieza por qué es oMLX y en qué se diferencia de Ollama y por la guía de instalación en un M5 Max. La versión 0.7.1.dev1 incluye el PR jundot/omlx#4315[2], fusionado el 6 de octubre de 2026, que añade un tipo de modelo de decisión con su propio motor.
Antes de ese cambio, Clef se cargaba como un modelo de visión cualquiera. El PR lo describe así: "Before this change oMLX loaded these checkpoints as plain VLMs and returned meaningless text." Ahora el panel lo marca como DECISION y la API de chat lo rechaza. Lo comprobé con una llamada a /v1/chat/completions contra clef-flash-oQ4e:
HTTP 400
Model 'clef-flash-oQ4e' is not an LLM / chat model.
Use /v1/systemone for decision models.
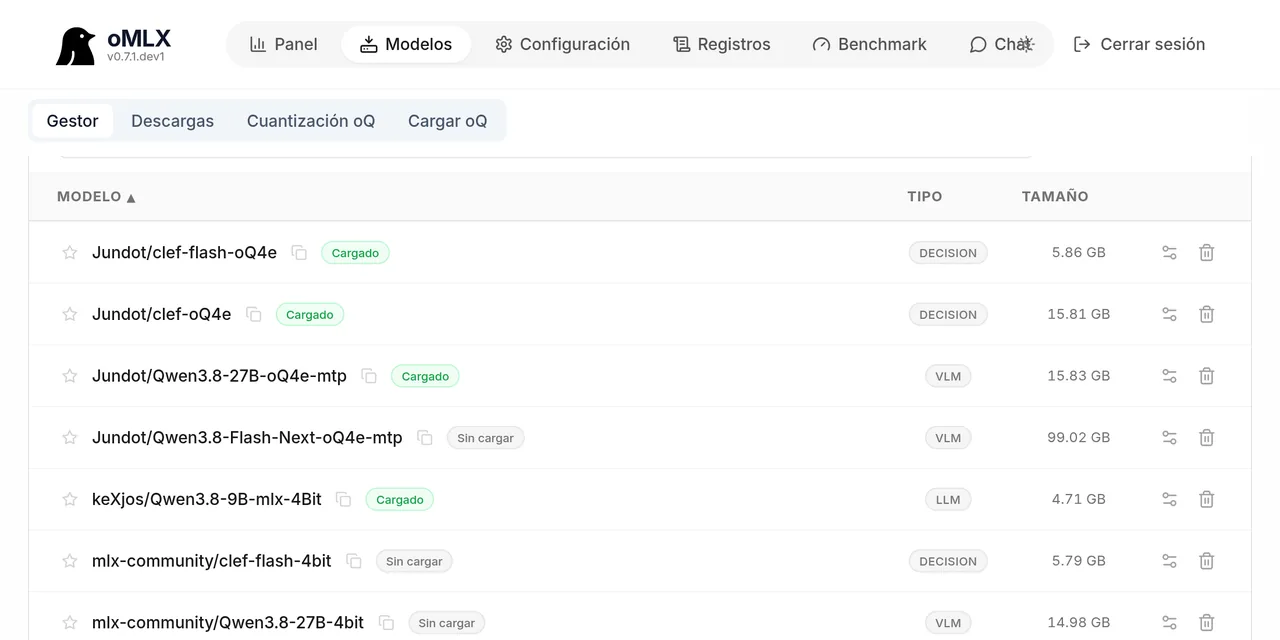
Estos son los cuatro modelos que usé, con el tamaño que muestra el panel de oMLX:
| Modelo | Tipo en oMLX | Tamaño | Para qué |
|---|---|---|---|
clef-flash-oQ4e |
DECISION | 5,86 GB | Decidir rápido: etiqueta, urgencia, ruta |
clef-oQ4e (27B) |
DECISION | 15,81 GB | Juzgar y revisar borradores |
Qwen3.8-9B-mlx-4Bit |
LLM | 4,71 GB | Respuestas cortas |
Qwen3.8-27B-oQ4e-mtp |
VLM | 15,83 GB | Respuestas que importan |
Cómo se llama a Clef por /v1/systemone
Una petición a /v1/systemone lleva un state (el texto que se evalúa) y un mapa de questions. Esta clasifica un ticket en cuatro etiquetas y, en la misma llamada, pregunta si el cliente está bloqueado. Si tu servidor tiene clave de API, añade la cabecera Authorization: Bearer, como explica la guía de clave, puerto y endpoints de oMLX:
curl -s http://localhost:8000/v1/systemone \
  -H "Content-Type: application/json" -d '{
  "model": "clef-flash-oQ4e",
  "state": "Al pulsar Exportar a PDF la app se cierra",
  "questions": {
    "etiqueta": {"type": "choice",
      "instructions": "¿Qué etiqueta corresponde al ticket?",
      "criteria": {"facturacion": "Cobros, facturas y reembolsos",
        "cuenta": "Acceso, contraseñas y usuarios",
        "error": "Fallos del software",
        "peticion": "Ideas y funciones nuevas"}},
    "urgente": {"type": "noul",
      "instructions": "¿El cliente no puede trabajar?"}}}'
La respuesta trae la opción elegida, la probabilidad de cada etiqueta y la confianza. Para la pregunta noul devuelve un único número: la probabilidad de que la condición se cumpla. El campo output_tokens es 0, porque Clef no genera nada:
{
  "model": "clef-flash-oQ4e",
  "answers": {
    "etiqueta": {
      "type": "choice",
      "choice": "error",
      "confidence": 0.9431,
      "probabilities": {
        "facturacion": 0.0236,
        "cuenta": 0.0082,
        "error": 0.9431,
        "peticion": 0.0251
      }
    },
    "urgente": {"type": "noul", "noul": 0.3582}
  },
  "usage": {"input_tokens": 278, "output_tokens": 0}
}
Cuánto tarda y cuánto acierta cada modelo en un M5 Max
Clef-flash es 3,3 veces más rápido que Clef 27B y falla un ticket más de 40. Medí cada modelo con 40 tickets etiquetados a mano (28 en español y 12 en inglés, 10 por etiqueta y 7 urgentes), con dos preguntas por llamada: la etiqueta y la urgencia.
| Modelo | Carga en frío | Mediana | Etiqueta | Urgencia |
|---|---|---|---|---|
clef-flash-4bit |
1,5 s | 111 ms | 39/40 | 36/40 |
clef-flash-oQ4e |
2,0 s | 111 ms | 39/40 | 38/40 |
clef-oQ4e (27B) |
3,7 s | 371 ms | 40/40 | 39/40 |
El único fallo de Clef-flash fue "Los acentos salen como símbolos raros en los informes exportados", que puso en facturación con una confianza de 0,59. El acierto con menos confianza estuvo en 0,67, así que un umbral de 0,6 lo habría mandado a una persona.
El coste de Clef crece con el texto que lee, no con lo que devuelve. El prefill rondó los 2600 tokens/s: 811 tokens tardaron 0,32 s, 6955 tokens 2,6 s y 16 384 tokens 6,4 s. A partir de 16 384 tokens de entrada, oMLX trunca el texto.
Qwen, en cambio, se mide por tokens generados por segundo:
| Modelo | Carga en frío | Generación | Clasificar (mediana) | Etiqueta | Urgencia |
|---|---|---|---|---|---|
Qwen3.8-9B-mlx-4Bit |
2,7 s | 94 tokens/s | 252 ms | 40/40 | 31/40 |
Qwen3.8-Flash-Next-oQ4e-mtp |
31,6 s | 59 tokens/s | 483 ms | 40/40 | 35/40 |
Qwen3.8-27B-oQ4e-mtp |
8,8 s | 27–29 tokens/s (42,7 con MTP) | 901 ms | 40/40 | 37/40 |
Como clasificador puro, Qwen etiqueta bien los 40 tickets, pero juzga peor la urgencia y es entre 2,3 y 8 veces más lento que Clef-flash. Para métodos y cifras de memoria del propio servidor, tienes los benchmarks y el techo de memoria de oMLX.
Qué optimizaciones funcionaron y cuáles no
Dos ajustes cambiaron los números y uno no. Medí cada uno con y sin el cambio, sobre los mismos textos:
| Ajuste | Resultado | Decisión |
|---|---|---|
| Lightning MTP (Multi-Token Prediction) en Qwen 27B | 29,3 → 42,7 tokens/s (+46 %), 30 ms más hasta el primer token | Activado |
| Prefill en el Apple Neural Engine (ANE) para Clef-flash | Entre un 3 y un 7 % menos con textos cortos y medios, 1 % a 16k: dentro del ruido | Apagado |
| Todas las preguntas en una sola llamada | 2 preguntas 123 ms, 5 → 209 ms, 11 → 408 ms, 21 → 742 ms | Agrupar |
| Clef-flash oQ4e frente a 4bit | Misma velocidad; oQ4e acertó 38 urgencias frente a 36 | oQ4e |
El MTP estaba apagado tras actualizar a 0.7.x y no lo noté hasta medirlo, así que revisa ese interruptor en la configuración del modelo después de cada actualización. Agrupar preguntas compensa porque Clef lee el texto común una vez por petición: cinco preguntas cuestan 209 ms, no cinco veces 123.
Ejemplo 1: triaje de tickets con Clef-flash, Qwen y un revisor
El triaje usa los tres papeles: Clef-flash decide, Qwen 9B escribe y Clef 27B revisa el borrador antes de enviarlo. Todo el código usa solo la biblioteca estándar de Python. Guarda este cliente mínimo como omlx_min.py; lee la URL de OMLX_URL y, si existe, la clave de OMLX_API_KEY:
import json, os, urllib.request

URL = os.environ.get("OMLX_URL", "http://localhost:8000")
KEY = os.environ.get("OMLX_API_KEY")
HEAD = {"Content-Type": "application/json"}
if KEY:
    HEAD["Authorization"] = f"Bearer {KEY}"

def post(path, body):
    req = urllib.request.Request(URL + path, headers=HEAD,
                                 data=json.dumps(body).encode())
    with urllib.request.urlopen(req, timeout=300) as r:
        return json.load(r)

def decide(model, state, questions):
    body = {"model": model, "state": state, "questions": questions}
    return post("/v1/systemone", body)["answers"]

def chat(model, system, user, max_tokens=160, **extra):
    msgs = [{"role": "system", "content": system},
            {"role": "user", "content": user}]
    r = post("/v1/chat/completions", {
        "model": model, "messages": msgs, "max_tokens": max_tokens,
        "chat_template_kwargs": {"enable_thinking": False}, **extra})
    return r["choices"][0]["message"]["content"].strip()
Las preguntas del triaje van en triaje.py. La pregunta persona decide si el ticket necesita a alguien de tu equipo, y su redacción importa, como verás después:
import sys
from pprint import pprint
from omlx_min import decide, chat

CLEF, REVISOR = "clef-flash-oQ4e", "clef-oQ4e"
QWEN = "Qwen3.8-9B-mlx-4Bit"
PREGUNTAS = {
    "etiqueta": {"type": "choice",
        "instructions": "¿Qué etiqueta corresponde al ticket?",
        "criteria": {"facturacion": "Cobros, facturas y reembolsos",
                     "cuenta": "Acceso, contraseñas y usuarios",
                     "error": "Fallos del software",
                     "peticion": "Ideas y funciones nuevas"}},
    "persona": {"type": "noul", "instructions":
        "¿El cliente está enfadado, amenaza con acciones legales"
        " o pide algo que solo puede decidir una persona?"},
    "idioma": {"type": "choice",
        "instructions": "¿En qué idioma está escrito?",
        "criteria": {"es": "Español", "en": "Inglés"}},
}
El revisor recibe el ticket y el borrador juntos y responde a dos preguntas: si el borrador afirma datos que el ticket no da, y si afirma cómo funciona el producto:
REVISION = {
    "datos": {"type": "noul", "instructions": "¿La RESPUESTA afirma"
        " hechos concretos (fechas, importes, plazos, que algo ya se"
        " ha hecho) que el TICKET no da?"},
    "producto": {"type": "noul", "instructions": "¿La RESPUESTA"
        " afirma cómo funciona el producto, qué permite o qué planes"
        " hay, sin que el TICKET lo diga?"}}
La función une las tres llamadas. Si la confianza baja de 0,6 o Clef cree que hace falta una persona, el ticket no llega a Qwen. Si el revisor da 0,5 o más a cualquiera de sus dos preguntas, el borrador va a revisión en lugar de salir:
def triaje(ticket):
    d = decide(CLEF, ticket, PREGUNTAS)
    etiqueta, conf = d["etiqueta"]["choice"], d["etiqueta"]["confidence"]
    if conf < 0.6 or d["persona"]["noul"] >= 0.5:
        return {"ruta": "persona", "etiqueta": etiqueta}
    idioma = "español" if d["idioma"]["choice"] == "es" else "inglés"
    borrador = chat(QWEN, f"Eres el soporte de una aplicación. Responde"
        f" en {idioma}, en 2 o 3 frases. Ticket de {etiqueta}. No"
        " inventes fechas, importes, plazos ni cómo funciona el"
        " producto. Si falta un dato, pídeselo al cliente.", ticket)
    r = decide(REVISOR, f"TICKET: {ticket}\n\nRESPUESTA: {borrador}",
               REVISION)
    p = max(r["datos"]["noul"], r["producto"]["noul"])
    return {"ruta": "revisar" if p >= 0.5 else "enviar",
            "etiqueta": etiqueta, "confianza": round(conf, 3),
            "inventa": round(p, 3), "borrador": borrador}

pprint(triaje(" ".join(sys.argv[1:])), width=72)
Con OMLX_URL apuntando al Mac, este fue el resultado para un fallo de software y para un cliente enfadado:
$ python3 triaje.py \
    "Al guardar un cliente nuevo da error 500 y no se guarda nada"
{'borrador': 'Detecté un error 500 al guardar el cliente, pero para '
             'ayudarte necesito el número exacto del ticket, el '
             'dispositivo que usas, la información que intentaste '
             'ingresar y el mensaje de error completo que muestra la '
             'aplicación. Con esos datos podré investigar si es un '
             'problema de la plataforma, una falta de permisos o un '
             'requisito incompleto.',
 'confianza': 0.912,
 'etiqueta': 'error',
 'inventa': 0.08,
 'ruta': 'enviar'}
$ python3 triaje.py \
    "Me habéis cobrado dos veces y como no lo arregléis hoy os denuncio"
{'etiqueta': 'facturacion', 'ruta': 'persona'}
El ticket sobre una API pública muestra por qué el revisor está ahí. Qwen no escribe con temperatura 0 en este ejemplo, así que cada ejecución da un borrador distinto. En una ejecución anterior escribió "our roadmap does not include plans to release a public API", una afirmación sobre el producto que el ticket no respalda, y Clef 27B le dio 0,871: a revisión. En esta otra, el borrador evita prometer nada y pasó con 0,256:
$ python3 triaje.py "Any plans for a public API with webhooks?"
{'borrador': 'I am currently unable to provide details about future '
             'API or webhook roadmaps as that information is not '
             'available in the support system. Please direct inquiries '
             'regarding product development plans to our product team '
             'or community forums. If you have a specific technical '
             'implementation question about the current API, feel free '
             'to ask.',
 'confianza': 0.936,
 'etiqueta': 'peticion',
 'inventa': 0.256,
 'ruta': 'enviar'}
Sobre los 40 tickets, la combinación acertó 39 etiquetas frente a 34 cuando Qwen 9B clasificaba y respondía en un mismo JSON. La mediana de extremo a extremo fue de 0,86 s frente a 0,79 s. Pedirle a Qwen las dos cosas a la vez le hace clasificar peor: solo clasificando acertaba 40 de 40.
La redacción de persona fue el ajuste más rentable. Con "enfado, legal, datos personales, algo ambiguo", Clef mandó a revisión 6 tickets bien etiquetados (4 de facturación y 2 de cuenta) con confianzas de 0,77 a 0,98. Con la redacción actual, que nombra lo que de verdad necesita a una persona, ninguno. Salieron solos 39 y el único que fue a revisión era el mal etiquetado, con una confianza de 0,57.
Para el revisor, el tamaño importa. Aun con la orden "no inventes", Qwen 9B dejó de inventar fechas e importes pero siguió afirmando cosas del producto. Sobre 39 borradores, Clef-flash marcó 1 y Clef 27B marcó 5, en unos 0,5 s por borrador. Entre ellos, uno que afirmaba que la aplicación no permite ascender a un compañero a administrador (0,90) y otro que negaba planes de una API pública (0,82).
Ejemplo 2: Clef 27B como juez de respuestas con contexto
En la generación aumentada por recuperación (RAG), el riesgo es que el modelo conteste con algo que el contexto no dice. Aquí Qwen responde con una política de devoluciones como contexto y Clef 27B decide si la respuesta se apoya en ella. Si no, se pide a Qwen una segunda respuesta que solo use el contexto. Guárdalo como juez.py junto a omlx_min.py:
import sys
from pprint import pprint
from omlx_min import decide, chat

CLEF, QWEN = "clef-oQ4e", "Qwen3.8-9B-mlx-4Bit"
CONTEXTO = ("Política de devoluciones de Tienda Acme: el cliente"
    " puede devolver un producto en 30 días desde la entrega. El"
    " reembolso se hace al mismo medio de pago en un máximo de 14"
    " días. Los productos personalizados no admiten devolución. El"
    " envío de la devolución es gratuito en España peninsular; en"
    " Canarias cuesta 6 €.")
JUEZ = {"apoyada": {"type": "noul", "instructions":
    "¿Todo lo que afirma la RESPUESTA está respaldado por el CONTEXTO?"}}
SOLO = ("Responde en una frase usando SOLO el contexto. Si no lo dice,"
        " dilo así y ofrece pasar la consulta a una persona.")
apoyo() es la única llamada a Clef: une contexto, pregunta y respuesta en el state y devuelve la probabilidad de que todo esté respaldado. atender() envía la primera respuesta si supera 0,5 y, si no, pide la segunda:
def responder(pregunta, sistema):
    return chat(QWEN, sistema, f"Contexto: {CONTEXTO}\n\n"
                f"Pregunta: {pregunta}", max_tokens=90, temperature=0)

def apoyo(pregunta, respuesta):
    estado = (f"CONTEXTO: {CONTEXTO}\n\nPREGUNTA: {pregunta}\n\n"
              f"RESPUESTA: {respuesta}")
    return round(decide(CLEF, estado, JUEZ)["apoyada"]["noul"], 3)

def atender(pregunta):
    primera = responder(pregunta, "Responde en una frase, como"
                        " atención al cliente de Tienda Acme.")
    p = apoyo(pregunta, primera)
    if p >= 0.5:
        return {"respuesta": primera, "apoyada": p}
    segunda = responder(pregunta, SOLO)
    return {"primera": primera, "apoyada_primera": p,
            "respuesta": segunda, "apoyada": apoyo(pregunta, segunda)}

pprint(atender(" ".join(sys.argv[1:])), width=72)
Estas fueron dos ejecuciones, una con una pregunta que el contexto no responde y otra que sí:
$ python3 juez.py "¿Hacéis cambios por otra talla?"
{'apoyada': 0.766,
 'apoyada_primera': 0.266,
 'primera': 'Sí, podemos gestionar el cambio de talla siempre que el '
            'producto no sea personalizado y se encuentre dentro del '
            'plazo de 30 días desde la entrega.',
 'respuesta': 'No se menciona en el contexto si hacéis cambios por '
              'otra talla.'}
$ python3 juez.py "¿Cuántos días tengo para devolver un producto?"
{'apoyada': 0.99,
 'respuesta': 'Tiene 30 días desde la entrega para devolver el '
              'producto.'}
La primera respuesta sobre tallas era una invención razonable, y el juez le dio 0,266. La segunda reconoce que el contexto no lo dice, aunque Qwen no ofreció pasar la consulta a una persona como pedía la orden.
En la prueba completa usé 10 preguntas: 5 se responden con el contexto y 5 no. En 4 de las 5 que no, Qwen 9B se inventó la respuesta: tiendas en Barcelona, cambios de talla, devoluciones de lo comprado en tienda y el coste desde Portugal. La quinta, "el reembolso no es en efectivo", sí se deduce del contexto. Así puntuaron los dos jueces:
| Juez | Invenciones marcadas | Deducción correcta marcada | Tiempo por juicio |
|---|---|---|---|
| Clef-flash | 2 de 4 | No | 109–129 ms |
| Clef 27B | 4 de 4 | No | 345–355 ms en caliente |
Clef 27B marcó además una respuesta respondible que añadía "tras recibir el producto en nuestro almacén", algo que el contexto no dice. Es un adorno, pero un juez estricto debe marcarlo. Si ya mides tu RAG, este juez encaja como una métrica más en la evaluación de un sistema RAG.
Qué pasa cuando Qwen y Clef trabajan a la vez
Los dos modelos comparten la GPU, y cuando coinciden, Clef pierde más que Qwen. Con Qwen 27B generando a la vez, Clef-flash pasó de 125 a 243 ms por decisión, porque oMLX le cede la GPU entre trozos de prefill. Qwen perdió un 6 %, de 28,5 a 26,9 tokens/s.
La memoria no es el problema: los cuatro modelos suman 42,2 GB, por debajo del techo de unos 75 GB que oMLX se reserva en esta máquina. El problema son las cargas en frío y un error de 0.7.1.dev1. Si oMLX expulsa el modelo de decisión mientras codifica una petición, /v1/systemone devuelve un 500, según el issue jundot/omlx#4413[3]. El arreglo ya está en el repositorio, pero llega después de 0.7.1.dev1.
La solución en ambos casos es fijar los modelos desde la configuración de cada uno en el panel. La gestión de modelos en oMLX explica cómo combinar el fijado con el TTL y la expulsión por uso.
Dificultades con las que me he topado al montar Qwen y Clef en el mismo servidor
Estos son los detalles que me costaron una ejecución o un resultado equivocado:
- Desactiva el razonamiento de Qwen: pasa
"chat_template_kwargs": {"enable_thinking": false}en cada llamada de chat, para que Qwen no dedique tokens a razonar antes de escribir dos frases - Escribe las
instructionscomo lo que quieres detectar: "ambiguo" o "datos personales" disparan escalados sin motivo; "pide algo que solo puede decidir una persona" no - Mantén el
statecorto: cada 2600 tokens de texto suman un segundo, y por encima de 16 384 tokens oMLX lo trunca sin error - Usa el modelo justo para cada papel: Clef-flash para decidir y Clef 27B para revisar, porque el revisor pequeño dejó pasar 4 de los 5 borradores que marcó el grande
- Revisa el MTP tras cada actualización: tras pasar a 0.7.x estaba apagado y Qwen 27B rendía un 46 % menos
Preguntas frecuentes
¿Puedo usar Clef como modelo de chat en oMLX?
No. Desde 0.7.1.dev1, una llamada a /v1/chat/completions con un modelo Clef devuelve un 400 que te remite a /v1/systemone. En versiones anteriores se cargaba como un modelo de visión normal y devolvía texto sin sentido.
¿Clef-flash o Clef 27B?
Clef-flash para decidir en línea: 111 ms y 39 de 40 etiquetas con 5,86 GB. Clef 27B para revisar y juzgar, donde los fallos cuestan más: cazó las 4 invenciones del RAG de prueba frente a 2, a cambio de 371 ms y 15,81 GB.
¿Cuánta memoria necesito para tener los cuatro modelos cargados?
En el panel suman 42,2 GB: 5,86 de Clef-flash, 15,81 de Clef, 15,83 de Qwen 27B y 4,71 de Qwen 9B, más la caché de cada petición. En este Mac de 128 GB quedan por debajo del techo de unos 75 GB de oMLX. Con menos memoria, empieza por Clef-flash y Qwen 9B, que juntos ocupan 10,6 GB.
Conclusión
Qwen y Clef en un mismo oMLX dan un reparto claro: Clef decide en 111 ms con probabilidades que puedes umbralizar, y Qwen solo escribe cuando hace falta. En mis pruebas, esa división subió el triaje de 34 a 39 etiquetas correctas, y Clef 27B como revisor cazó las invenciones que Qwen 9B coló a pesar de la orden de no inventar.
El siguiente paso es fijar los cuatro modelos, activar el MTP en Qwen 27B y probar el triaje con 50 tickets reales de tu cola antes de dejar que responda solo.
Fuentes: [1] Introducing Clef, blog de Cloudflare[1], [2] jundot/omlx#4315, modelos de decisión en /v1/systemone[2], [3] jundot/omlx#4413, error 500 al expulsar el modelo de decisión[3], [4] Cloudflare/clef-flash en Hugging Face[4], [5] Cloudflare/clef en Hugging Face[5], [6] mlx-community/clef-flash-8bit en Hugging Face[6].
Fuentes
Código fuente
Accede a todo el código fuente de este artículo en GitHub.
Ver en GitHub