Cómo arreglar «this model requires MLX support» en Ollama para Linux y Windows
Índice de contenidos
- Puntos clave
- ¿Qué significa el error this model requires MLX support?
- Por qué falla: cómo decide Ollama que un modelo necesita MLX
- Qué modelos y etiquetas exigen MLX
- Cómo arreglarlo: descarga la variante GGUF
- Actualiza a Ollama 0.40.4 o posterior
- Fuerza el motor con --runner llamacpp
- Cómo saber si una etiqueta es solo MLX antes de descargarla
- Si tienes una GPU de NVIDIA en Linux
- Preguntas frecuentes
- ¿Puedo convertir un modelo solo MLX a GGUF?
- ¿Me afecta en un Mac con Apple Silicon?
- ¿Por qué ollama list no muestra el modelo después del error?
- Conclusión
- Fuentes
El error this model requires MLX support, but the MLX runtime is not available significa que la etiqueta que pides solo existe en formato safetensors para MLX y tu Ollama no puede cargar ese motor, y se arregla descargando la variante GGUF del mismo modelo. Le pasa a quien usa Linux arm64, Linux sin GPU de NVIDIA o Windows con etiquetas como embeddinggemma-2:740m-bf16, cualquier -mxfp8 o -nvfp4, o el modelo de voz phonon. Lo reproduje el 27 de octubre de 2026 con Ollama 0.40.11 en Docker, en arm64 y en amd64 emulado. Hay una versión en inglés de esta guía.
Puntos clave
- Ollama comprueba el motor antes de descargar nada: si el manifiesto trae capas de tipo tensor y MLX no carga, corta en
pulling manifest. - El 28 de octubre de 2026 la categoría MLX de ollama.com tenía 132 etiquetas con pesos descargables en 15 modelos: 74 son solo MLX, y
phonony los cuatro modeloslfm3no tienen ninguna otra. - Cuatro etiquetas
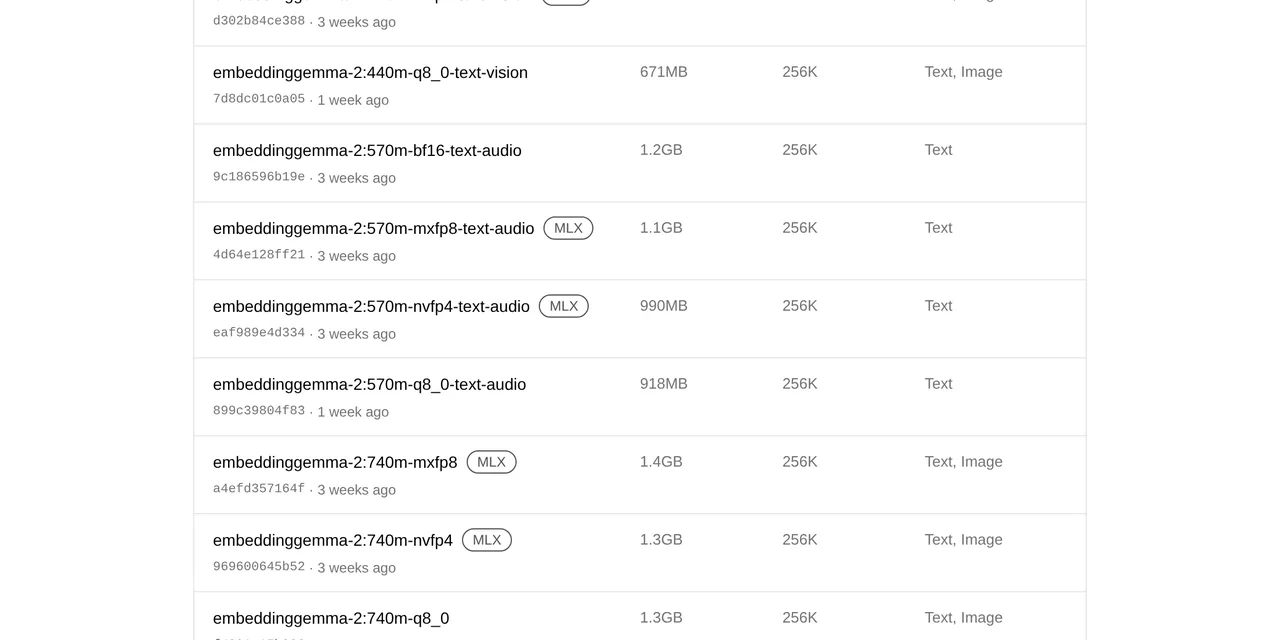
bf16deembeddinggemma-2son solo MLX y la web no les pone la insignia MLX. - La salida es la etiqueta
q8_0, que es GGUF, pero exige Ollama 0.40.4 o posterior: la 0.40.0 responde que necesitas una versión nueva. - La imagen Docker amd64 trae MLX para CUDA 13 (2,0 GB), pero sin el controlador de NVIDIA falla al cargar
libmlxc.so; la arm64 no lo trae.
¿Qué significa el error this model requires MLX support?
Significa que Ollama ha leído el manifiesto del modelo, ha visto que solo contiene pesos para su motor MLX y no ha podido cargar ese motor en tu máquina. MLX es el framework de aprendizaje automático de Apple; desde la 0.40, Ollama lo usa para ejecutar modelos en formato safetensors, mientras que los modelos GGUF van por llama.cpp. Estos son los mensajes exactos que obtuve en Linux arm64 con Ollama 0.40.11:
$ ollama pull embeddinggemma-2:740m-bf16
pulling manifest
Error: this model requires MLX support, but the MLX runtime is not available

$ ollama run embeddinggemma-2:740m-bf16 hola
pulling manifest
Error: this model requires MLX support, but the MLX runtime is not available

$ ollama pull phonon:es
pulling manifest
Error: this model requires MLX support, but the MLX runtime is not available
El fallo llega antes de bajar un solo byte del modelo, así que no te deja ficheros a medias. Si descargas desde otra aplicación por la API, la respuesta es un HTTP 500 con el mismo texto (aquí partido en dos líneas):
$ curl -s http://localhost:11434/api/pull \
    -d '{"model":"phonon:es","stream":false}'
{"error":"this model requires MLX support,
 but the MLX runtime is not available"}
Por qué falla: cómo decide Ollama que un modelo necesita MLX
Ollama decide por el manifiesto. En la versión 0.40.11, la función requiresMLX de server/images.go mira primero el campo runner del manifiesto. Si no existe, considera MLX cualquier modelo con capas application/vnd.ollama.image.tensor, que son los pesos en safetensors. Si la respuesta es sí, llama a mlx.CheckInit(), y si la biblioteca MLX no cargó al arrancar el servidor, devuelve el error.
La documentación de desarrollo de Ollama resume dónde existe ese motor: "The MLX engine enables running safetensor based models. On macOS arm64, MLX is enabled by default. On other platforms, MLX backends are selected with OLLAMA_MLX_BACKENDS." Fuera del Mac, el único motor MLX que se compila es el de CUDA 13, para GPU de NVIDIA. Lo comprobé dentro de las dos imágenes oficiales de ollama/ollama:0.40.11:
| Plataforma | Biblioteca MLX en la imagen | Resultado sin GPU |
|---|---|---|
| Linux arm64 | no existe | error al descargar |
| Linux amd64 | /usr/lib/ollama/mlx_cuda_v13/libmlxc.so |
error al descargar |
| macOS con Apple Silicon | incluida (Metal) | no aplica |
En amd64 la biblioteca está, pero depende de libcuda.so.1, que aporta el controlador de NVIDIA. Sin GPU, ldd la marca como not found y el registro del servidor lo dice al pedir el modelo:
level=ERROR source=dynamic.go:33 msg="failed to load MLX dynamic
library: path=/usr/lib/ollama/mlx_cuda_v13/libmlxc.so"
En Windows el error es el mismo: un usuario lo reprodujo con tres etiquetas de embeddinggemma-2 en la incidencia 18825 de Ollama[1], abierta el 6 de octubre de 2026 y con 16 votos a favor. Allí, el colaborador del proyecto pdevine respondió que MLX aún no estaba disponible en Linux ni en Windows.
Qué modelos y etiquetas exigen MLX
Las etiquetas solo MLX siguen un patrón de nombre, con una excepción que confunde. Descargué los manifiestos de las etiquetas con pesos descargables de la categoría MLX de ollama.com el 27 de octubre de 2026 y repetí el recuento el 28, tras la versión 0.40.12. Estas son las que no funcionan sin MLX:
| Modelo | Etiquetas solo MLX | Alternativa GGUF |
|---|---|---|
phonon (voz) |
las 14 | ninguna |
lfm3, lfm3-vl, lfm3-audio, lfm3-omni (nuevos en la 0.40.12) |
las 5 de cada uno, latest incluida |
ninguna |
d1, d1-omni |
las 2b (4 en cada uno) |
3b en d1, 600m en d1-omni, latest |
embeddinggemma-2 |
-bf16, -mxfp8, -nvfp4 (12) |
-q8_0, latest |
d3 |
-mxfp8, -nvfp4 (7) |
resto de etiquetas |
clef, nimble, nimble-v3, pplx-decider, nemotron-3.5-bolt |
-mlx-bf16, -mxfp8, -nvfp4 |
resto de etiquetas |
clef-flash |
-mlx-bf16, -mxfp8 |
resto de etiquetas |
flint |
-mlx-bf16, -qat-int4 |
resto de etiquetas |
laya |
-mlx-fp16 (3) |
-bf16, latest |
El 28 de octubre comprobé con Ollama 0.40.12 en Linux arm64 que ollama pull lfm3 y ollama pull d1:2b acaban en este mismo error. Las notas de esa versión lo avisan: «lfm3 and d1 2b are supported on Apple hardware in this release. Support for Linux/Windows coming soon.»
La trampa está en bf16. En embeddinggemma-2, 740m-bf16 es solo MLX, pero en laya, 322m-multilingual-bf16 es un GGUF que descargué y ejecuté en Linux sin problema. Además, la web de Ollama no marca con la insignia MLX las cuatro etiquetas bf16 de embeddinggemma-2, el fallo que recoge la incidencia 18971[2]. La incidencia se cerró el 17 de octubre, pero el 28 la web seguía sin ponérsela. Hasta mediados de octubre, embeddinggemma-2:latest también apuntaba a una variante MLX; según esa incidencia, el 16 de octubre ya apuntaba a 740m-q8_0.
Cómo arreglarlo: descarga la variante GGUF
El arreglo es cambiar de etiqueta, no de configuración. Para embeddinggemma-2, usa la variante q8_0 del tamaño que quieras. Así quedó en mi prueba:
$ ollama pull embeddinggemma-2:270m-q8_0-text
writing manifest
success

$ ollama list
NAME                               ID              SIZE
embeddinggemma-2:270m-q8_0-text    c21dd30c1e38    303 MB
Después comprueba que el modelo responde y qué motor lo sirve. La petición a /api/embed con dos frases devolvió dos vectores de 768 dimensiones, y ollama ps mostró llamacpp en la columna RUNNER:
$ curl -s http://localhost:11434/api/embed -d '{
  "model": "embeddinggemma-2:270m-q8_0-text",
  "input": ["El error de MLX en Linux", "MLX runtime error"]}'

$ ollama ps
NAME                               SIZE      PROCESSOR    RUNNER
embeddinggemma-2:270m-q8_0-text    528 MB    100% CPU     llamacpp
He recortado columnas de ollama ps para que quepa. Si el error te llega desde una herramienta que fija el modelo por nombre, como la configuración de Open WebUI con Docker y Ollama, cambia allí la etiqueta. Después vuelve a generar los embeddings, porque los vectores de dos variantes distintas no son intercambiables.
Actualiza a Ollama 0.40.4 o posterior
Las variantes GGUF de embeddinggemma-2 declaran que necesitan Ollama 0.40.4, la versión que añadió los embeddings multimodales con llama-server el 12 de octubre de 2026. Con la 0.40.0, la etiqueta MLX da el error de este artículo y la GGUF da otro distinto:
$ ollama --version
ollama version is 0.40.0
$ ollama pull embeddinggemma-2:270m-q8_0-text
The model you are attempting to pull requires a newer version of Ollama.
$ ollama show embeddinggemma-2:270m-q8_0-text   # con 0.40.11
    requires            0.40.4
En Docker, fija ollama/ollama:0.40.11 o una versión posterior y recrea el contenedor; los modelos viven en el volumen y no se pierden.
Fuerza el motor con –runner llamacpp
ollama pull acepta una opción oculta, --runner, que no aparece en ollama pull --help. Con --runner llamacpp, Ollama elige la variante GGUF cuando la etiqueta la tiene. Con una etiqueta solo MLX, el error cambia y deja claro que no hay alternativa:
$ ollama pull --runner llamacpp embeddinggemma-2:740m
success
$ ollama pull --runner llamacpp phonon:es
Error: no compatible manifest found for runners: llamacpp
El artículo sobre Ollama 0.40 y MLX por defecto en Mac explica cómo elige Ollama el motor en cada plataforma y qué muestra la columna RUNNER.
Cómo saber si una etiqueta es solo MLX antes de descargarla
El registro de Ollama sirve el manifiesto de cada etiqueta sin autenticación, y una etiqueta solo MLX lleva capas image.tensor. Esta función de shell lo comprueba sin descargar el modelo:
mlx_only() {
  if curl -s "https://registry.ollama.ai/v2/library/$1/manifests/$2" \
      | grep -q image.tensor; then echo "$1:$2 -> MLX"
  else echo "$1:$2 -> GGUF"; fi
}
mlx_only phonon es               # phonon:es -> MLX
mlx_only embeddinggemma-2 740m-q8_0  # embeddinggemma-2:740m-q8_0 -> GGUF
mlx_only nimble 9b-nvfp4         # nimble:9b-nvfp4 -> MLX
Los tres resultados de los comentarios son los que obtuve. No te fíes de la insignia de la web: las cuatro etiquetas bf16 de embeddinggemma-2 dan MLX con esta función y no la llevan.
Si tienes una GPU de NVIDIA en Linux
Con una GPU de NVIDIA, la imagen amd64 sí puede cargar MLX, porque trae la biblioteca para CUDA 13. Las notas de la 0.40.4 mencionan mejoras de "Gemma 4 prefill performance on NVIDIA GPUs with the MLX runner". Para que el contenedor la cargue necesitas el NVIDIA Container Toolkit, --gpus all y un controlador compatible con CUDA 13.
No tengo una GPU de NVIDIA en este equipo, así que no he podido probar este camino. En la incidencia 18971, otro usuario lo resolvió instalando libquadmath0 dentro del contenedor el 13 de octubre; en la imagen 0.40.11 que revisé, libquadmath.so.0 ya viene en mlx_cuda_v13. Si sigues viendo el error con GPU, busca la línea failed to load MLX dynamic library en el registro y ejecuta ldd sobre esa ruta para ver qué biblioteca falta.
Preguntas frecuentes
¿Puedo convertir un modelo solo MLX a GGUF?
No con el propio registro de Ollama: lo que descargas de una etiqueta solo MLX son pesos safetensors y no hay un comando de Ollama que los convierta. Si el modelo original está en Hugging Face, puedes convertirlo a GGUF con las herramientas de llama.cpp e importarlo como explica la guía para importar un modelo de Hugging Face en Ollama. Para phonon no hay variante GGUF publicada.
¿Me afecta en un Mac con Apple Silicon?
Con la aplicación oficial de Ollama no debería, porque incluye MLX con Metal y la documentación lo activa por defecto en macOS arm64. Lo verás si la biblioteca MLX no carga; en ese caso, el registro del servidor muestra la misma línea failed to load MLX dynamic library con la ruta del fichero .dylib. No lo he probado en un Mac para este artículo.
¿Por qué ollama list no muestra el modelo después del error?
Porque Ollama no descarga nada: comprueba el motor justo después de leer el manifiesto. No hay ficheros que borrar ni caché que limpiar; descarga otra etiqueta y listo.
Conclusión
this model requires MLX support, but the MLX runtime is not available es un problema de etiqueta: pediste pesos para MLX en un equipo sin MLX. En Linux arm64, Linux sin GPU de NVIDIA o Windows, actualiza a Ollama 0.40.4 o posterior y descarga la variante q8_0 o latest. Antes de cambiar una etiqueta en producción, comprueba su manifiesto con la función mlx_only, porque la insignia de la web no es fiable. Si el modelo solo existe para MLX, como phonon, necesitas un Mac o un servidor con GPU de NVIDIA.
Fuentes: [1] Ollama, incidencia 18825: Failed to pull embeddinggemma-2:740m on linux[1], [2] Ollama, incidencia 18971: etiquetas sin insignia MLX[2], [3] Ollama, notas de la versión v0.40.4[3], [4] Ollama, guía de desarrollo y motor MLX[4], [5] Ollama, código de server/images.go en v0.40.11[5], [6] ollama.com, etiquetas de embeddinggemma-2[6], [7] ollama.com, etiquetas de phonon[7].
Fuentes
Código fuente
Accede a todo el código fuente de este artículo en GitHub.
Ver en GitHub