Shieldstral es el clasificador de seguridad de 3B que Mistral publicó en agosto de 2026: responde sí o no a una política escrita en lenguaje natural. Convertido a GGUF Q8_0 con llama.cpp y servido en CPU, no bloqueó ninguno legítimo de los 100 prompts que preparé en español e inglés, pero dejó pasar 8 de 17 inyecciones.
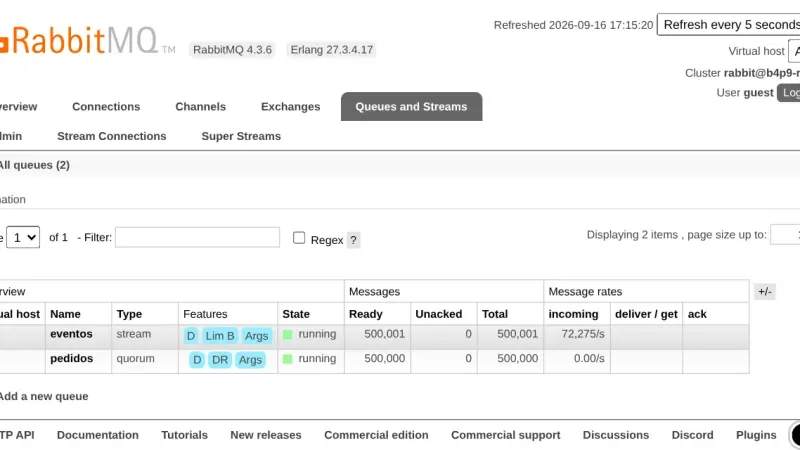
Una cola quorum de RabbitMQ borra cada mensaje al confirmarlo y hace fsync antes de aceptarlo; un stream lo guarda para releerlo. En RabbitMQ 4.3.6, con mensajes de 1 KB, la cola quorum movió 45 156 msg/s y el stream, por su protocolo, 281 330 msg/s, con 9 KB de memoria por millón de mensajes frente a 20,5 MB.
OpenCode usa un modelo local si declaras en opencode.json un proveedor @ai-sdk/openai-compatible con la URL de llama-server u Ollama y el límite de contexto del modelo. La versión 1.18.31 envía 7.516 tokens en su primer turno, así que los 4k que Ollama asigna por defecto sin GPU grande no bastan: reserva 32k.
Para instalar OpenBao con Docker, arranca la imagen openbao/openbao:2.6.2 con almacenamiento Raft en un volumen, inicialízala con bao operator init y deséllala con tres de las cinco claves. OpenBao es la bifurcación de HashiCorp Vault con licencia MPL 2.0 y mantiene su API, así que tus aplicaciones leen los secretos igual.
Docker Compose 5.3.0, publicado el 2 de julio de 2026, añade init containers con la clave pre_start: pasos que se ejecutan en contenedores efímeros, en orden, antes de arrancar el servicio. Sirven para migraciones, permisos de volúmenes y configuración generada. Compose 2.40.3 rechaza el fichero entero, y cada paso debe ser idempotente porque se repite.
Para migrar Langfuse de v3 a v4 con Docker Compose, sube primero ClickHouse a 26.4 sin tocar Langfuse, copia PostgreSQL y ClickHouse, arranca la v4 en modo de doble escritura, rellena el histórico y pasa a events_only cuando todos tus SDK sean compatibles. Lo probé con 45 931 trazas y tres versiones del SDK de Python.
File Browser quedó archivado el 31 de agosto de 2026 y su v2.63.23 arrastra al menos 8 vulnerabilidades publicadas que ya no tendrán parche. Tras probar las alternativas en Docker sobre la misma carpeta, FileBrowser Quantum es el sustituto directo, copyparty la opción ligera para compartir ficheros grandes y Filestash la adecuada si tus datos están en S3, SFTP o SMB.
CrowdSec 1.8 añade a su WAF una detección de bots, todavía en alfa, que sirve a cada visitante una página con prueba de trabajo y huella del navegador. Se activa con la colección appsec-bot-challenge y sus configuraciones en la adquisición AppSec, siempre detrás de un bouncer compatible como el de OpenResty 1.2.3.
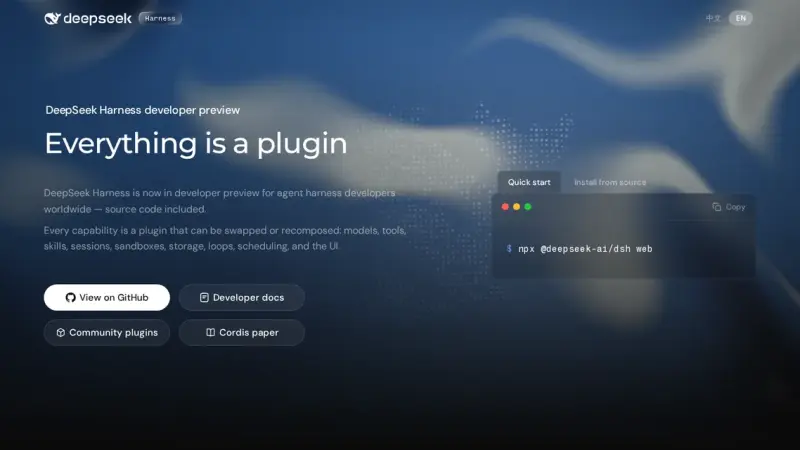
DeepSeek Harness (dsh) es el arnés de agentes de código abierto que DeepSeek publicó en agosto de 2026. Funciona con un modelo local si declaras en settings.yaml un proveedor openai-completions que apunte a llama-server, con una clave de relleno y el contexto real. Con Qwen3.5-4B en CPU dejó los tests en verde en 4 de 5 intentos, pero despacio.
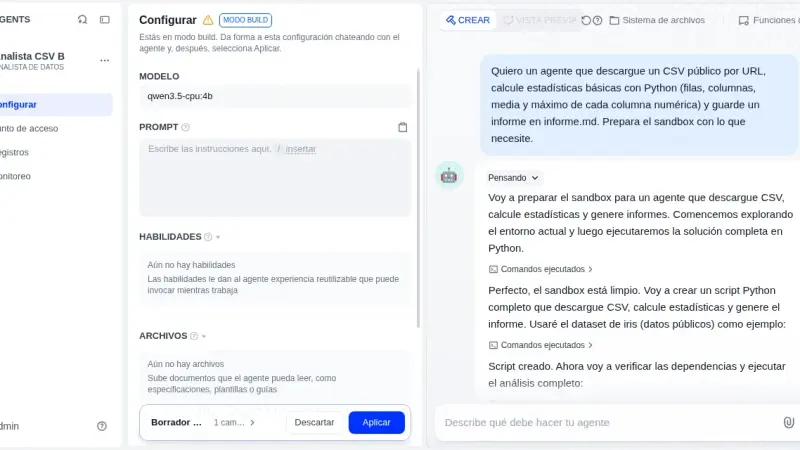
Dify Agent, el agente con sandbox Linux de Dify 1.16, funciona con un modelo local si instalas el plugin de Ollama y activas las llamadas a herramientas. Con Dify 1.17.1 y Qwen3.5-4B en CPU, el agente publicado dio cifras correctas en tres de tres pruebas; el modo Build no terminó ninguna de sus tres sesiones.
Paperless-ngx 3 sugiere título, etiquetas, corresponsal y fechas con un LLM y responde preguntas sobre tus documentos, todo en tu propio servidor con Ollama. Se actualiza desde la 2.20.15 cambiando la etiqueta de la imagen. En CPU, Gemma 4 E4B tardó 25,8 s por sugerencia y ocupó unos 7 GiB, si esquivas un fallo con los modelos que razonan.
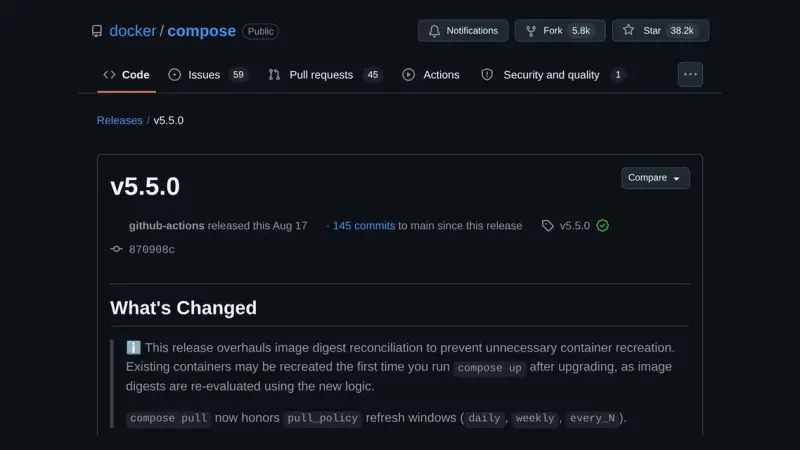
Docker Compose 5.5 cambia el digest con el que decide si la imagen de un contenedor ha cambiado. Con el almacén de imágenes de containerd, los contenedores que Compose 2.40 o un up de 5.4 con descarga etiquetaron con el digest del índice se recrean una vez en el primer up, sin cambios reales. up --dry-run los señala antes.
Sin GPU, en una CPU arm64 de 18 núcleos con llama.cpp v0.4.1, Maple-Preview generó 172,84 tokens/s con 6 hilos: el doble que MiniCPM5-2B y 3,6 veces Spark-X2.5-4B. A cambio ocupa 5,79 GiB de RAM y siempre razona. MiniCPM5 cabe en 3,27 GiB y Spark escribe mejor en español. Los tres inventaron datos.
n8n 3.0 aún no ha salido: n8n la prevé para octubre de 2026 y la versión estable es la 2.39.6. Para preparar tu instalación con Docker, abre Settings > Migration Report, sustituye los nodos retirados, fija los valores por defecto que cambian, pasa binaryData a storage y prueba la imagen v3-nightly sobre una copia.
OpenClaw 2026.9.4 se instala con Docker Compose desde la imagen oficial de GHCR, que existe para amd64 y arm64. Para usarlo sin API en la nube, conéctalo a un llama-server en la red interna del compose. Publica el puerto 18789 solo en 127.0.0.1, porque el compose del repositorio lo abre en todas las interfaces.
Desde Ollama 0.34.1, ollama create ya no convierte ni cuantiza pesos safetensors. Para importar un modelo de Hugging Face, descárgalo con hf download, conviértelo a GGUF con convert_hf_to_gguf.py de llama.cpp, cuantízalo con llama-quantize y créalo desde un Modelfile. Con MiniCPM5-2B en CPU, las tres fases tardaron 35 s, 21 s y 2 s.
Jellyfin 12.0 salió el 8 de septiembre de 2026 y reescribe la base de datos al arrancar, así que no hay vuelta atrás sin copia. En Docker, el camino seguro es parar el contenedor, copiar /config, quitar los complementos de terceros, cambiar la etiqueta a 12.0, migrar y lanzar un escaneo completo.
Las imágenes de MinIO ya no se descargan de Docker Hub y la copia de quay.io está congelada en 2025. Para migrar de MinIO a Garage con Docker, levanta Garage v2.4.1 junto a MinIO, copia los buckets con rclone sync, verifícalos con rclone check y cambia endpoint, claves y región en los clientes.
Para instalar llama.cpp tienes cuatro vías: el script de llama.app, que deja un binario llama de 15 MB en ~/.local/bin; Homebrew; la imagen Docker server-v0.4.1; o CMake. Las probé el 14 de septiembre de 2026 en Linux arm64 con Gemma 4 E2B, en la terminal con llama cli y como API compatible con OpenAI.
Para instalar Forgejo con Docker usa la imagen codeberg.org/forgejo/forgejo:16.0, que desde el 10 de septiembre de 2026 es la 16.0.4 y corrige un fallo crítico de ejecución remota. Ponla detrás de Caddy fijando REVERSE_PROXY_TRUSTED_PROXIES a la IP del proxy y registra Forgejo Runner 13 con la URL pública de la instancia.
Open Storage for Proxmox es un plugin de almacenamiento GPL-3.0 que se instala en cada nodo de Proxmox VE. Crea en TrueNAS 25.10 un zvol por disco, lo publica por iSCSI o NVMe/TCP a través de la API, sin SSH, y añade snapshots y clones de ZFS. Va por la versión 2.1.23~beta3.
Colibri es un motor de inferencia en C, con licencia Apache 2.0, que ejecuta modelos Mixture-of-Experts de hasta 2,8 billones de parámetros sin cargarlos enteros: deja en RAM la parte densa y lee del SSD solo los expertos que el router elige en cada token. Por eso su velocidad depende del disco, de la caché y de la RAM libre.
Engram es un binario en Go con SQLite y FTS5 que da memoria persistente a los agentes de código a través de MCP. Guarda decisiones y convenciones entre sesiones, se sincroniza por git y no necesita Node, Python ni Docker. Su búsqueda es léxica, no semántica, y eso condiciona qué conviene guardar.
n8n no es software libre: su Sustainable Use License limita el uso a fines internos de tu empresa y prohíbe cobrar por alojarlo. Activepieces publica su núcleo bajo MIT, pero deja fuera agentes, proyectos y API. Windmill compila en AGPLv3 desde el código, aunque la Community Edition que se distribuye no es abierta.
ThinkingBox es un sandbox de Microsoft, con licencia MIT, que ejecuta un agente contra herramientas MCP con estado y lo juzga por los efectos que deja en el sistema, no por lo que dice haber hecho. Su banco de pruebas mide 507 tareas de negocio repitiendo cada una veinte veces.
Jellyfin es un servidor multimedia libre con licencia GPL-2.0 que no pide cuenta ni suscripción. Se instala con el compose oficial, que publica el puerto 8096 y monta tres volúmenes separados para configuración, caché y biblioteca. La versión estable en agosto de 2026 es la 10.11.11 y la transcodificación por hardware viene incluida.
k3s y k0s son distribuciones de Kubernetes que instalas sobre un Linux que sigues administrando tú; Talos Linux es un sistema operativo inmutable, sin consola ni gestor de paquetes, que se gobierna por una API y ejecuta Kubernetes original. No son capas: eliges una de las tres, y la decisión depende de cuántos nodos tengas.
La búsqueda agéntica consiste en que el modelo planifique sus propias consultas contra el repositorio con grep, listados de ficheros y el servidor de lenguaje, en vez de consultar un índice de embeddings creado de antemano. Claude Code y Cline trabajan así por diseño, pero Cursor y Devin Desktop siguen indexando, y su documentación lo explica.
k3s es una distribución de Kubernetes conforme que cabe en un binario de 68 MiB y se instala con una sola orden. Trae containerd, Flannel, CoreDNS, Traefik, ServiceLB y almacenamiento local ya montados, guarda el estado en SQLite y deja un nodo funcionando en tres segundos.
Karakeep es un gestor de marcadores autoalojado que guarda enlaces, notas, imágenes y PDF, archiva la página entera con monolith y los vídeos con yt-dlp, y los etiqueta con un modelo de lenguaje. Se instala con un compose de tres contenedores y el etiquetado admite tanto un modelo alojado como un Ollama propio.
Agent Lightning es el marco de Microsoft Research que entrena por refuerzo el modelo de un agente ya escrito. El agente apunta su cliente de OpenAI al proxy de Agent Lightning en lugar del modelo, y el proxy graba peticiones, respuestas y recompensas mientras el agente conserva sus herramientas y su flujo de control.
Pangolin es un proxy inverso con túnel y control de identidad que se instala en un VPS con Docker Compose. El conector Newt abre la conexión desde tu red hacia el servidor, así que en casa no queda ningún puerto escuchando, y Traefik emite los certificados de Let's Encrypt en el otro extremo.
La revisión 2026-07-28 convierte MCP en un protocolo sin estado. Desaparecen el intercambio initialize y la cabecera Mcp-Session-Id, y la versión de protocolo y las capacidades del cliente viajan dentro del campo _meta de cada petición. A cambio, Roots, Sampling y Logging quedan deprecados con doce meses de margen.
Qwen3-VL 8B en Q4_K_M son 4,68 GiB de pesos más 1,08 GiB de torre de visión, y su cache KV cuesta 144 KiB por token. Con 8.192 tokens de contexto la suma ronda los 7 GiB y cabe de sobra en 16 GB; con los 256K nativos pediría 36 GiB solo de cache y no cabe en ninguna tarjeta de consumo.
Obscura es un motor de navegador headless escrito en Rust y publicado bajo licencia Apache-2.0. Ejecuta JavaScript sobre V8, habla el protocolo Chrome DevTools y sustituye a Chrome headless en Playwright o Puppeteer sin tocar el código. Su ventaja medida es la memoria: unos 38 MB por sesión frente a los 532 MB de Chromium.
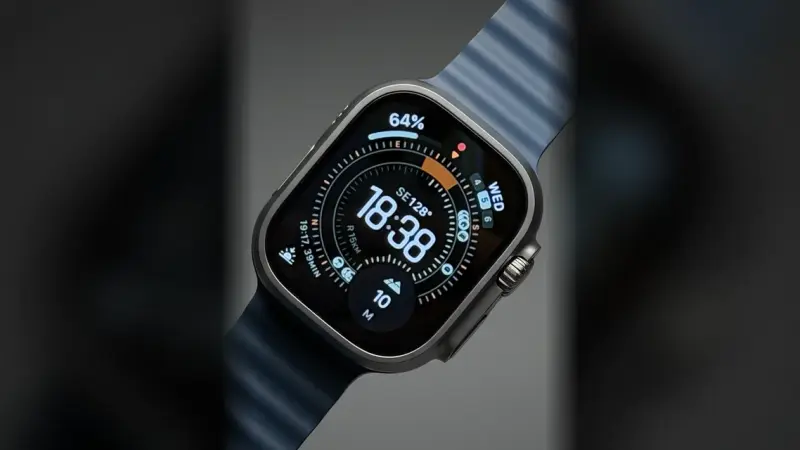
El Apple Watch Ultra 3 no ejecuta Siri AI por su cuenta. El modelo se ejecuta en el iPhone emparejado con Apple Intelligence y en Private Cloud Compute, y Apple no lanza Siri AI en la Unión Europea por su conflicto con la DMA. En España el reloj se queda con Workout Buddy, la Siri clásica del dispositivo y las alertas de salud.
Immich se instala con dos ficheros que descargas de su última publicación, el docker-compose.yml y el .env, y un docker compose up -d. El servidor queda escuchando en el puerto 2283, la aplicación móvil sube el carrete sola y la copia de seguridad tiene que incluir la base de datos, no solo las fotos.
Herdr es un multiplexor de terminal escrito en Rust que ejecuta tus agentes de código dentro de un servidor en segundo plano. Marca cada panel como trabajando, bloqueado o inactivo, y ese estado sube hasta el espacio de trabajo, así que sabes de un vistazo cuál agente te está esperando.
Gemma 4 llega en cinco tamaños con licencia Apache 2.0. Cuantizados a 4 bits, los pesos van de 2,9 GB en el E2B a 17,5 GB en el 31B según la tabla de Google, así que la variante la decide tu memoria. Y la ventana de 256K suma otros 10 GiB de caché.
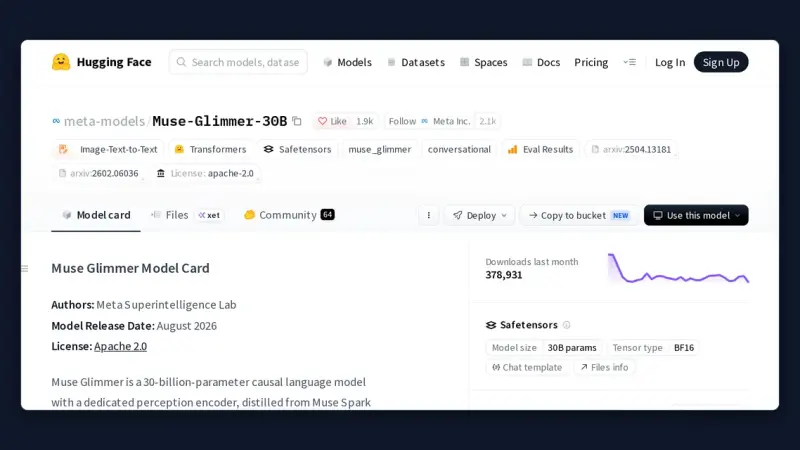
Agosto de 2026 dejó una decena de modelos con pesos realmente descargables, y también varios nombres que solo existen como API alojada. Los que cambian lo que cabe en un equipo propio son Muse Glimmer 30B y Qwen3.8-27B, ambos con licencia Apache 2.0, más Ling-3.0-tiny para máquinas pequeñas.
Muse Code es el agente de terminal que Meta Superintelligence Labs publicó en beta el 5 de agosto de 2026. Funciona con Muse Spark 1.2, coordina subagentes persistentes, anota cada llamada y cada edición en un registro local de eventos, y se instala con una sola orden en macOS y en Linux.
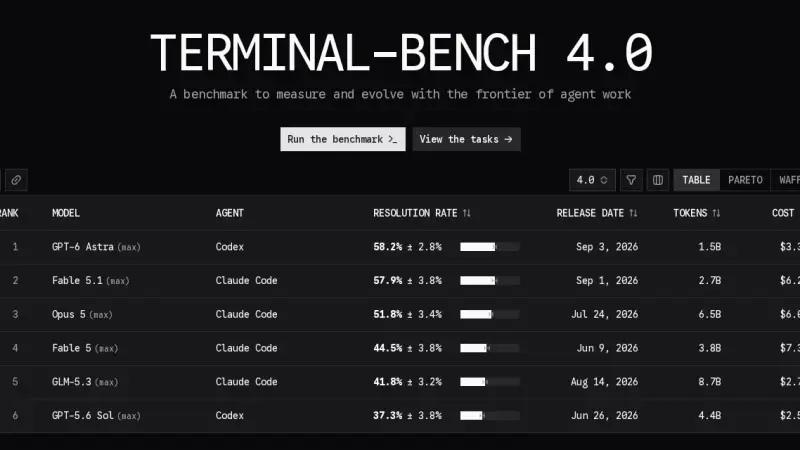
Los tres son agentes de terminal, pero apuestan por cosas distintas. En el Terminal-Bench 4.0 oficial, publicado el 28 de agosto de 2026, Claude Code con Opus 5 resuelve el 51,8 % de los intentos a 18,09 dólares cada uno, y Codex con GPT-5.6 Sol el 37,3 % a 7,70. Muse Code no figura en ninguna tabla.
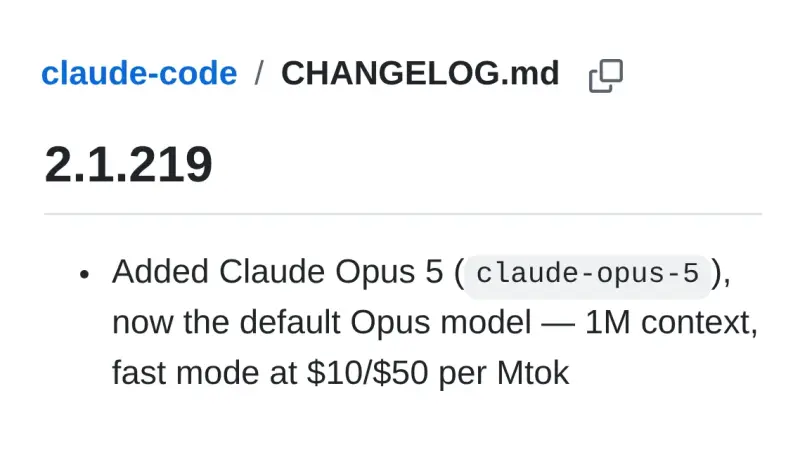
Entre el 1 de junio y el 28 de agosto de 2026 se publicaron 81 versiones de Claude Code, de la 2.1.160 a la 2.1.251, con 149 novedades. Las cuatro que cambian cómo se trabaja son Claude Opus 5 por defecto, la mensajería entre sesiones, los entornos autoalojados y el enmascarado de credenciales en el sandbox.
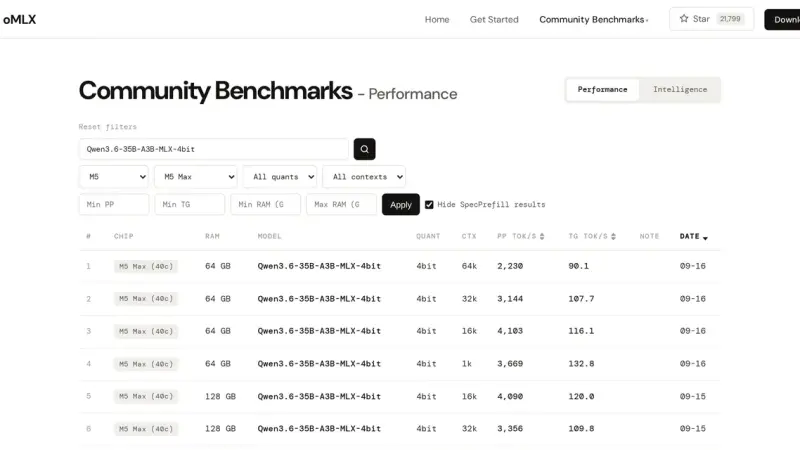
oMLX trae un banco de pruebas en el panel que mide tiempo hasta el primer token, tiempo por token, tokens por segundo y pico de memoria, con prompts de 1.024 a 200.000 tokens. El techo de memoria por defecto es la RAM del sistema menos 8 GB, y es lo que decide qué contexto cabe.
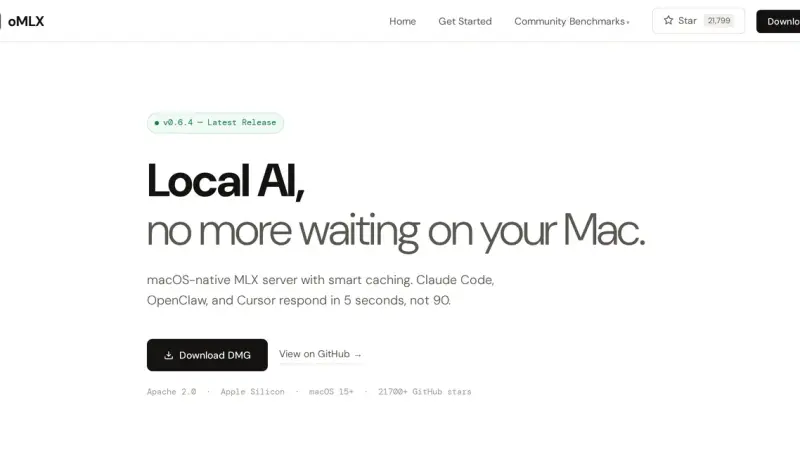
oMLX es un servidor de inferencia local para Mac con Apple Silicon que envuelve el framework MLX de Apple en un proceso web y lo expone con las API de OpenAI y de Anthropic. Añade lotes continuos, caché KV en disco y varios modelos en memoria a la vez, gobernados desde la barra de menús.
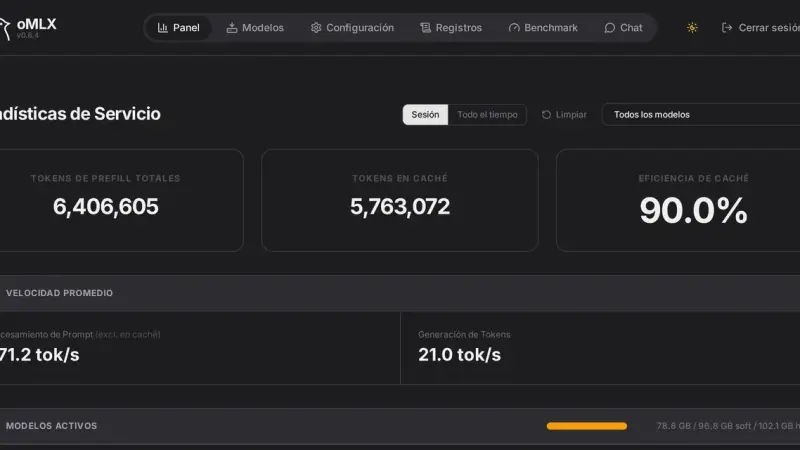
El panel de oMLX vive en localhost:8000/admin y reúne monitorización, carga y descarga de modelos, chat con historial, descargador de Hugging Face, benchmarks y ajustes por modelo. La línea de comandos cubre lo demás con cuatro órdenes: serve, start, stop y launch, esta última para conectar clientes externos.
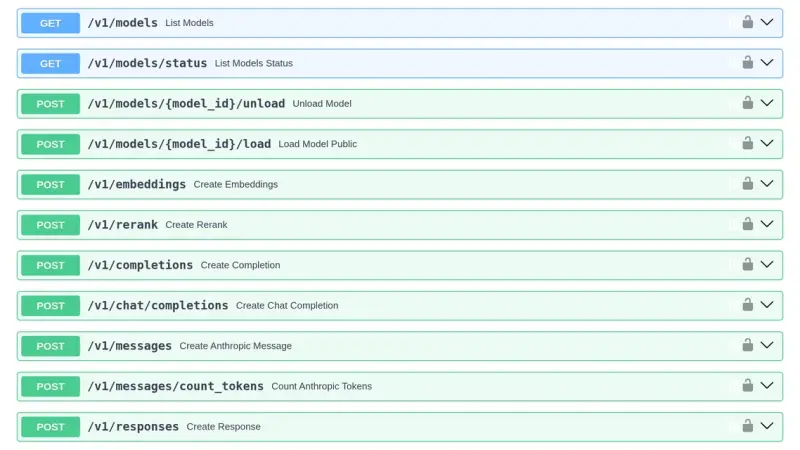
oMLX escucha por defecto en 127.0.0.1:8000 y expone ocho endpoints compatibles con OpenAI y con Anthropic. La clave de API viaja en la cabecera Authorization o en x-api-key, admite subclaves que solo llaman a la API y puede omitirse en conexiones locales. Todo se configura en settings.json, por variables de entorno o por banderas.
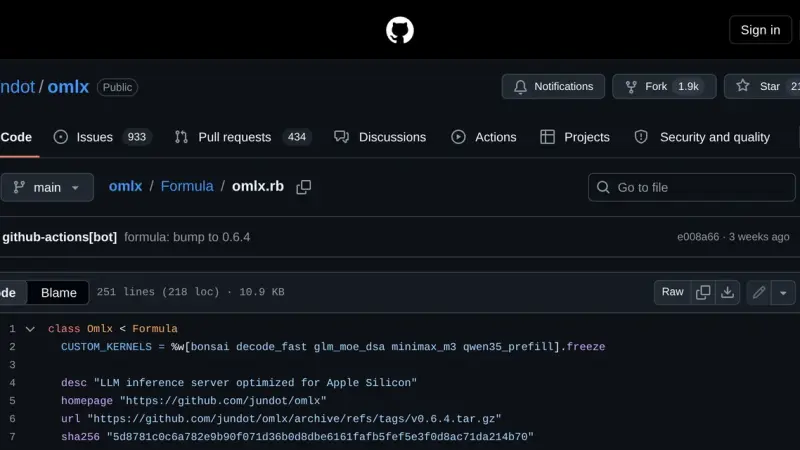
oMLX se instala con Homebrew en dos órdenes: primero el tap del repositorio de jundot y después la fórmula. Queda un servicio de launchd que arranca con omlx start, un registro en la carpeta var de Homebrew y una actualización con brew upgrade. La versión actual es la 0.6.4, del 29 de agosto de 2026.
9 min5
Usamos cookies propias y de terceros para analizar el tráfico del sitio. Puedes aceptarlas, rechazarlas o configurar tu elección.
Más información sobre las cookies
Preferencias de cookies
NecesariasImprescindibles para el funcionamiento del sitio. Siempre activas.
AnalíticasNos ayudan a entender cómo se usa el sitio (Google Analytics).