Qué es oMLX y en qué se diferencia de MLX, Ollama y LM Studio
Índice de contenidos
- Puntos clave
- Qué es oMLX exactamente
- oMLX no es MLX
- Cómo funciona por dentro
- oMLX frente a Ollama 0.40 y LM Studio en un Mac
- Cuál elegir
- Cómo compararlos en tu propio Mac
- Por qué no hay versión para Windows, Linux ni Docker
- Preguntas frecuentes
- ¿oMLX y MLX son lo mismo?
- ¿oMLX es más rápido que Ollama?
- ¿Puedo instalar oMLX en Windows o en Linux?
- ¿Qué modelos admite oMLX?
- Conclusión
- Fuentes
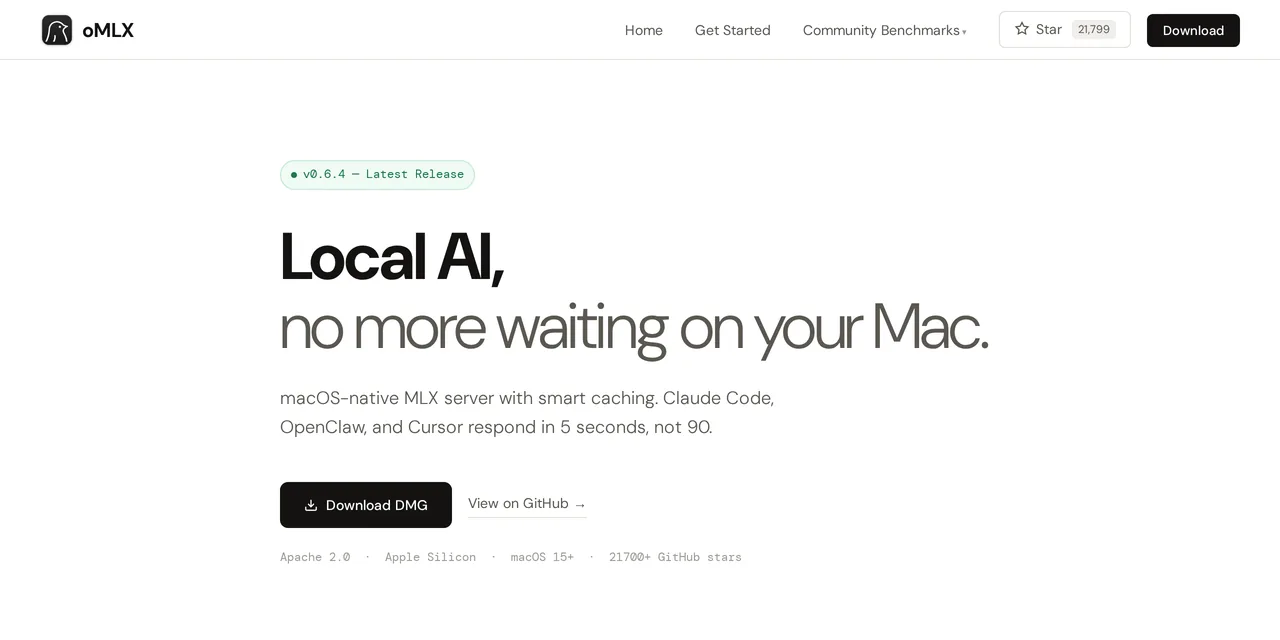
oMLX es un servidor de inferencia local para Mac con Apple Silicon que convierte el framework MLX de Apple en un servicio permanente con las API de OpenAI y de Anthropic. La confusión más habitual es tomarlo por el framework de Apple, del que solo le separa una letra. Este artículo aclara qué es cada cosa y compara oMLX con Ollama 0.40 y LM Studio tal como están a 27 de octubre de 2026, para que decidas cuál te conviene. Las velocidades medidas de oMLX están en otra página, enlazada al final.
Puntos clave
- oMLX es un servidor, no un framework. Envuelve MLX, la biblioteca de cálculo de Apple, en un proceso con endpoints web y una aplicación nativa en la barra de menús.
- La última versión estable es la 0.7.2, del 21 de octubre de 2026, con licencia Apache 2.0.
- Desde Ollama 0.40, Ollama también ejecuta con MLX en un Mac los modelos que tienen variante MLX, y LM Studio sirve modelos MLX desde hace tiempo. El motor ya no es lo que los distingue.
- Lo que sí distingue a oMLX es la gestión de memoria: modelos cargados a la vez con expulsión, fijado y TTL, un techo de memoria propio y una caché KV que se vuelca al SSD y sobrevive a los reinicios.
- Los tres hablan ya la API de OpenAI y la Messages API de Anthropic, así que los tres sirven a Claude Code.
Qué es oMLX exactamente
oMLX es un servidor de modelos de lenguaje que se ejecuta en tu Mac y los expone por HTTP. El propio proyecto lo resume como inferencia con lotes continuos y caché KV por niveles, gobernada desde la barra de menús de macOS.
Por dentro es un proceso FastAPI que envuelve MLX y las bibliotecas mlx-lm y mlx-vlm. Encima añade tres cosas que MLX no trae. Son un grupo de motores que mantiene más de un modelo en memoria, una caché de claves y valores repartida entre RAM y SSD, y endpoints compatibles con OpenAI y con Anthropic.
Lo publica el desarrollador jundot en el repositorio jundot/omlx, con licencia Apache 2.0. La aplicación es nativa, escrita en Swift y SwiftUI, no un envoltorio de navegador: arranca y detiene el servidor, guarda estadísticas de uso y se actualiza sola. El ritmo de versiones es alto: la 0.7.1 salió el 20 de octubre, la 0.7.2 al día siguiente y la 0.7.3rc1 el 27 de octubre.
oMLX no es MLX
Esta es la distinción que más búsquedas genera, y cada nombre corresponde a una capa distinta:
- MLX: el framework de Apple para cálculo con matrices sobre la memoria unificada de los chips de la serie M, con una API parecida a la de NumPy. Ejecuta las operaciones, pero no sirve modelos ni habla HTTP.
- mlx-lm: la biblioteca de encima, que carga modelos de lenguaje y genera texto. Es lo que usas en un guion de Python.
- oMLX: la capa de servicio. Mete mlx-lm en un proceso que escucha en un puerto, reparte la memoria entre los modelos cargados y responde en los formatos que tus clientes ya conocen.
Dicho de otra forma: MLX ejecuta el modelo, y oMLX decide qué modelo está cargado, cuánta memoria ocupa, quién puede llamarlo y en qué formato.
Cómo funciona por dentro
Tres piezas explican casi todo su comportamiento. La primera es el grupo de motores, que carga modelos de lenguaje, de visión, de embeddings, reordenadores y modelos de decisión. Expulsa el menos usado cuando falta memoria, permite fijar modelos para que no se descarguen nunca y admite un tiempo de vida por modelo.
Un vigilante de memoria impone el techo total. En el nivel por defecto, balanced, reserva para macOS y el resto de aplicaciones el 8 % de la RAM, con un mínimo de 3 GB y un máximo de 8 GB. En un Mac de 128 GB deja unos 120 GB para modelos y caché.
La segunda es la caché KV por niveles, su rasgo distintivo. Trabaja por bloques con prefijos compartidos, un diseño tomado de vLLM. Los bloques calientes se quedan en RAM y los fríos se vuelcan al SSD en formato safetensors. Si llega otra petición con el mismo prefijo, los bloques se leen del disco en lugar de recalcularse, también después de reiniciar el servidor.
La tercera son los lotes continuos, que atienden peticiones simultáneas con el generador por lotes de mlx-lm en lugar de ponerlas en cola. El número máximo de peticiones concurrentes se ajusta en el panel o en la línea de comandos.
oMLX frente a Ollama 0.40 y LM Studio en un Mac
Los tres sirven modelos locales en un Mac con Apple Silicon, y en octubre de 2026 se parecen más de lo que se parecían en primavera. La tabla recoge lo que dice la documentación de cada uno, consultada el 27 de octubre de 2026:
| oMLX 0.7.2 | Ollama 0.40 | LM Studio | |
|---|---|---|---|
| Plataformas | Solo macOS 15 o superior con Apple Silicon | macOS, Linux y Windows | macOS, Linux y Windows |
| Motor en un Mac | MLX; GGUF de algunos modelos con el motor externo Splash | MLX para los modelos con variante MLX; llama.cpp para el resto | llama.cpp para GGUF y MLX para modelos MLX |
| Interfaz | Barra de menús, panel web y CLI | CLI y aplicación | Aplicación de escritorio, CLI lms y modo sin interfaz |
| API de OpenAI | Sí, con Responses API | Sí | Sí, con Responses API |
| API de Anthropic | /v1/messages y count_tokens |
Un subconjunto de la Messages API | /v1/messages |
| Modelos cargados a la vez | Expulsión por uso, fijado, TTL por modelo y techo de memoria | Hasta 3 a la vez por defecto, descargados a los 5 minutos sin uso | TTL de 60 minutos y expulsión automática del modelo anterior al cargar otro |
| Caché KV en el SSD entre reinicios | Sí | No consta en su documentación | No consta en su documentación |
La fila que más ha cambiado es la del motor. Desde Ollama 0.40, los modelos que la biblioteca de Ollama publica con variante MLX se ejecutan con MLX en un Mac, como explico en Ollama 0.40 usa MLX por defecto. Comparar oMLX con Ollama ya no es comparar MLX con llama.cpp.
Cuál elegir
La decisión depende menos del motor que de cómo vas a usar la máquina:
- Ollama, si quieres el mismo flujo en tu Mac y en un servidor Linux, o si lo que buscas es descargar un modelo de su biblioteca y usarlo. La instalación en Mac está en cómo instalar Ollama en macOS.
- LM Studio, si quieres una aplicación de escritorio para buscar, probar y comparar modelos con interfaz gráfica, y servirlos de vez en cuando. Lo cuento en LM Studio, modelos desde el escritorio.
- oMLX, si el Mac tiene memoria de sobra y quieres tratarlo como un servidor para más de una herramienta a la vez: modelos fijados en memoria, otros que entran y salen solos, y una caché que conserva los prefijos largos de un asistente de programación entre sesiones.
oMLX también expone más ajustes del motor, como la decodificación especulativa con Lightning MTP, cuyo efecto medido está en la guía para instalar oMLX en un M5 Max. El precio es que el proyecto cambia deprisa: trátalo como una herramienta que actualizas leyendo las notas de cada versión.
Cómo compararlos en tu propio Mac
No he medido Ollama ni LM Studio en el Mac para este artículo, así que no hay aquí una cifra de cuál genera más tokens por segundo. Si quieres saberlo para tu caso, mide los tres por la misma vía: peticiones en streaming a su endpoint /v1/chat/completions, con la misma instrucción, la misma longitud de respuesta y la temperatura fija.
El banco de pruebas de oMLX tiene una opción, "Use external OpenAI API endpoint", que lanza su misma batería contra otro servidor compatible con OpenAI. El servidor externo tiene que devolver el uso de tokens en streaming (stream_options.include_usage), y esos resultados no se suben al ranking de omlx.ai. Antes de comparar, fija lo que más mueve los números: el contexto, la temperatura del Mac y si la caché está fría o caliente. Lo explico en cómo medir oMLX sin engañarte.
Por qué no hay versión para Windows, Linux ni Docker
oMLX es MLX, y MLX es de Apple. Está construido sobre la memoria unificada y el motor Metal de los chips de la serie M, en la que el procesador y la gráfica comparten el mismo espacio sin copias. Ese modelo de memoria no existe en un PC con una tarjeta gráfica dedicada.
De ahí salen los requisitos que publica el proyecto: macOS 15 o superior, Python entre la 3.11 y la 3.13 y un chip de la serie M1 a M5. Tampoco hay imagen de Docker, porque un contenedor en macOS corre dentro de una máquina virtual Linux sin acceso a Metal. Si tu equipo no es un Mac con Apple Silicon, la alternativa equivalente es Ollama o llama.cpp.
Preguntas frecuentes
¿oMLX y MLX son lo mismo?
No. MLX es el framework de cálculo de Apple para sus chips de la serie M. oMLX es un servidor independiente, del desarrollador jundot, que envuelve MLX y lo expone por HTTP con las API de OpenAI y de Anthropic. Añade gestión de memoria, caché en disco y más de un modelo cargado a la vez.
¿oMLX es más rápido que Ollama?
No hay una respuesta general, y este artículo no la mide. Desde Ollama 0.40 los dos usan MLX en un Mac para los modelos con variante MLX, así que la diferencia depende del modelo, de la cuantización y de ajustes como la decodificación especulativa. Mide los dos con la misma petición por la API, como se explica arriba.
¿Puedo instalar oMLX en Windows o en Linux?
No. oMLX depende de MLX, que solo funciona sobre Metal y la memoria unificada de Apple Silicon. Necesitas macOS 15 o superior y un chip de la serie M; en otras plataformas usa Ollama o llama.cpp.
¿Qué modelos admite oMLX?
Cualquier modelo de lenguaje que admita mlx-lm y los modelos de visión de mlx-vlm, como la serie Qwen3.5. También sirve OCR como DeepSeek-OCR, embeddings como BGE-M3 y EmbeddingGemma 2, reordenadores y modelos de decisión como Clef. Los ficheros GGUF de las carpetas de modelos se sirven con el motor externo Splash, que en la 0.7.2 admite modelos concretos de Qwen.
Conclusión
oMLX ocupa un hueco estrecho y lo ocupa bien: convertir un Mac con memoria de sobra en un servidor de modelos para más de una herramienta a la vez. Con Ollama y LM Studio ejecutando ya MLX y hablando la API de Anthropic, su ventaja está en la gestión de la memoria y en la caché que persiste, no en el motor.
Si quieres ver cuánto corre en la práctica, mira los benchmarks medidos en un M5 Max. Para instalarlo, la vía de Homebrew está en instalar, actualizar y desinstalar oMLX, y todas las guías, ordenadas, en la página de oMLX. La versión inglesa de este artículo está en What is oMLX.
Fuentes: [1] jundot/omlx, repositorio y documentación oficiales[1], [2] Notas de la versión 0.7.2 de oMLX[2], [3] MLX, el framework de aprendizaje automático de Apple[3], [4] Compatibilidad de Ollama con la API de Anthropic[4], [5] Preguntas frecuentes de Ollama[5], [6] Endpoints compatibles con Anthropic de LM Studio[6], [7] TTL y expulsión automática en LM Studio[7].
Fuentes
- jundot/omlx, repositorio y documentación oficiales
- Notas de la versión 0.7.2 de oMLX
- MLX, el framework de aprendizaje automático de Apple
- Compatibilidad de Ollama con la API de Anthropic
- Preguntas frecuentes de Ollama
- Endpoints compatibles con Anthropic de LM Studio
- TTL y expulsión automática en LM Studio
Código fuente
Accede a todo el código fuente de este artículo en GitHub.
Ver en GitHub