Qué cambia en oMLX 0.7.2 y cómo actualizarlo en tu Mac
Índice de contenidos
- Puntos clave
- Qué trae oMLX 0.7.2 y a quién le afecta
- Cuánto acelera DeepSeek V4.1 en oQ2e a oQ4e
- Qué cambia si usas oMLX con Claude Code
- Lightning MTP en inferencia distribuida entre dos o más Mac
- Modelos GGUF de Qwen3.8-Flash-Next en Splash
- Otros arreglos de la 0.7.2
- Cómo actualizar oMLX a la 0.7.2 según cómo lo instalaste
- App de macOS (DMG)
- Homebrew
- Desde el código fuente
- Qué revisar antes de actualizar
- Problemas conocidos de la 0.7.2
- Preguntas frecuentes
- ¿Merece la pena actualizar a oMLX 0.7.2 si ya tengo la 0.7.1?
- ¿La 0.7.2 cambia mis ajustes o mis modelos descargados?
- ¿Puedo instalar oMLX 0.7.2 con pip?
- Conclusión
- Fuentes
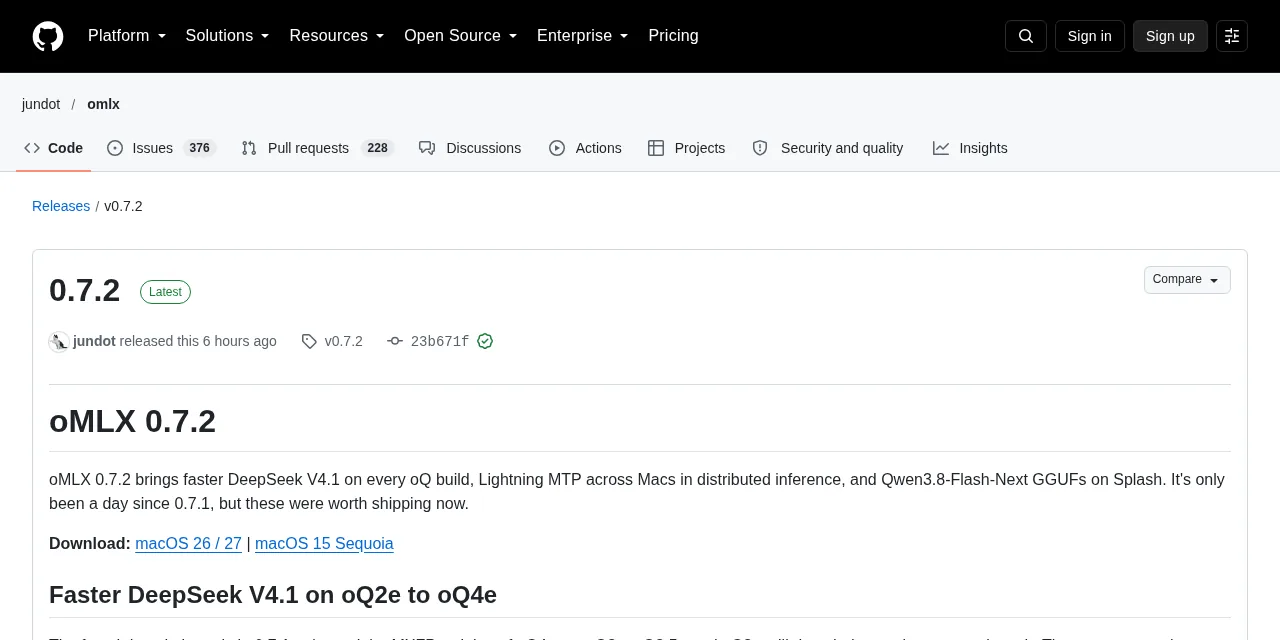
oMLX 0.7.2 se publicó el 21 de octubre de 2026 a las 11:07 (hora peninsular), menos de 24 horas después de la 0.7.1. oMLX es un servidor de modelos de lenguaje para Mac con Apple Silicon construido sobre MLX, el framework de aprendizaje automático de Apple; si no lo conoces, empieza por qué es oMLX y en qué se diferencia de Ollama y LM Studio. Esta versión acelera DeepSeek V4.1, lleva Lightning MTP a la inferencia distribuida, abre Splash a los GGUF de Qwen3.8-Flash-Next y corrige un fallo que hacía repetir el prefill entero en cada turno de Claude Code. Aquí tienes qué cambia, a quién le importa, cómo actualizar según cómo lo instalaste y qué revisar antes. También está la versión en inglés.
Puntos clave
- Si usas Claude Code contra oMLX, la 0.7.2 deja de mover al bloque de sistema inicial las notas que Claude Code envía tras un resultado de herramienta, así que un turno ya no vuelve a procesar toda la conversación.
- DeepSeek V4.1 decodifica entre un 72 y un 86 % más rápido en oQ2e, oQ2.5e y oQ3e sin MTP, según las pruebas del mantenedor en un M3 Ultra de 512 GB.
- Lightning MTP funciona ya en clústeres de dos o más Mac con DeepSeek V4.1 y GLM-5.3, y se activa solo si el checkpoint trae cabeza de borrador.
- Se actualiza desde la propia app (DMG), con
brew upgrade omlxo congit pullymake install. No hay paquete en PyPI. - Antes de actualizar, revisa dos cambios de comportamiento: DeepSeek V4.1 usa entre 4 y 7 GB más de memoria con un prompt de 16K y los clústeres activan MTP por defecto.
Qué trae oMLX 0.7.2 y a quién le afecta
La 0.7.2 es una versión pequeña en código y grande en efectos para tres perfiles concretos. Entre la 0.7.1 y la 0.7.2 hay 32 commits que tocan 136 archivos, con 5181 líneas añadidas y 1187 eliminadas, según la comparación de las dos etiquetas en GitHub[1]. El mantenedor, jundot, explica la prisa en las notas de la versión 0.7.2[2]: "It’s only been a day since 0.7.1, but these were worth shipping now."
Los cambios se reparten así:
| Perfil | Qué cambia en la 0.7.2 |
|---|---|
| Usas Claude Code con un modelo local | Las notas posteriores a un resultado de herramienta ya no fuerzan un prefill completo |
| Ejecutas DeepSeek V4.1 en oQ2e, oQ2.5e u oQ3e | Kernels fusionados de decodificación y prefill en bloques de 8192 tokens |
| Repartes un modelo entre dos o más Mac | Lightning MTP en divisiones por tuberías o por tensores, sin el atasco de 1 tok/s |
| Pruebas modelos GGUF con Splash | Qwen3.8-Flash-Next en GGUF y descarga de GGUF divididos en partes |
| Usas la interfaz web con teclado o tema oscuro | Menús accesibles con teclado, contraste WCAG AA y medidor de memoria visible |
Si ejecutas un Qwen o un Gemma en MLX en un solo Mac y no usas Claude Code, la 0.7.2 te aporta sobre todo arreglos de la interfaz y de la API. En mi M5 Max de 128 GB el panel de administración ya marca v0.7.2.
Cuánto acelera DeepSeek V4.1 en oQ2e a oQ4e
DeepSeek V4.1 es el modelo que más gana, porque la 0.7.1 solo aplicaba sus kernels fusionados a los pesos MXFP de oQ4e. Los cuantizados oQ2e, oQ2.5e y oQ3e (las variantes de 2, 2,5 y 3 bits del formato oQ de oMLX) seguían por una ruta genérica más lenta. Con la 0.7.2 también usan los kernels fusionados, la verificación de Lightning MTP comparte trabajo entre los tokens que comprueba y el prefill se procesa en bloques de 8192 tokens (PR #4722).
El gráfico muestra la decodificación sin MTP que publica el mantenedor para los checkpoints -mtp de DeepSeek-V4.1-Flash-1017[3]. oQ3e pasa de 22,9 a 42,7 tokens por segundo, un 86 % más:
Con Lightning MTP y CED activados, las notas dan un prefill de entre 949 y 1010 tokens por segundo con 16K, frente a los 700 a 773 de la 0.7.1. Según el mantenedor, se mantiene en torno a 900 hasta un prompt de 128K. El precio está en la memoria: el pico con un prompt de 16K sube entre 4 y 7 GB por los bloques de 8192 tokens.
Qué cambia si usas oMLX con Claude Code
Para quien programa con Claude Code contra un modelo local, este es el arreglo que más se nota en el día a día. Claude Code envía notas después de cada resultado de herramienta: el contexto de los hooks, las reglas cargadas y los recordatorios. Hasta la 0.7.1, oMLX las movía al bloque de sistema del principio, lo que cambiaba el inicio del prompt e invalidaba la caché de prefijos (PR #4712).
El efecto era que cada turno volvía a procesar la conversación entera. Por ejemplo, con 50.000 tokens de historial y un prefill de unos 1000 tokens por segundo, eso son casi 50 s de espera antes del primer token en cada respuesta. Ahora las notas se quedan en su sitio y la caché de prefijos sirve lo ya procesado.
La 0.7.2 añade otros dos cambios para este caso:
- Las peticiones del clasificador del modo automático de Claude Code reciben un presupuesto de razonamiento de 256 tokens, para que un modelo que piensa conteste antes del límite de tiempo del clasificador
- Splash mantiene también en su posición los mensajes de sistema posteriores y recibe la opción
preserve_thinking
Claude Code se conecta a oMLX por su endpoint compatible con Anthropic, /v1/messages, con ANTHROPIC_BASE_URL apuntando a tu servidor. Los detalles están en la guía de la clave de API, el puerto y los endpoints de oMLX.
Lightning MTP en inferencia distribuida entre dos o más Mac
La inferencia distribuida ejecuta ya Lightning MTP, la predicción de más de un token por paso de oMLX, en DeepSeek V4.1 y GLM-5.3 (PR #4732). Funciona con división por tuberías (cada Mac carga unas capas) y por tensores (cada Mac carga parte de cada capa). Se activa con la misma regla que en un solo Mac: cuando el checkpoint trae cabeza de borrador y el ajuste del modelo no lo desactiva.
El gráfico recoge la decodificación con muestreo que publica el mantenedor, con MTP apagado y encendido, en dos M3 Ultra unidos por Thunderbolt. La ganancia grande está en la división por tensores, donde GLM-5.3 duplica su velocidad:
La misma versión corrige un atasco que dejaba DeepSeek V4.1 en torno a 1 token por segundo entre dos Mac. Una etapa de la tubería esperando dejaba que su GPU bajara de frecuencia y frenaba el paso siguiente. Con la 0.7.2 esa configuración decodifica a unos 28 tokens por segundo sin MTP, según el mantenedor en la incidencia #4720[4].
El asistente del clúster avisa además en dos casos que antes fallaban en silencio. El primero es un puente Thunderbolt con una dirección autoasignada 169.254, que hacía que el clúster usara la red local o la wifi. El segundo es un enlace que va por wifi.
Modelos GGUF de Qwen3.8-Flash-Next en Splash
Splash es el motor externo que oMLX usa para servir modelos GGUF sin sacarlos de su lista de modelos, su API y su panel. Con Splash 1.4.0, los GGUF de Qwen3.8-Flash-Next funcionan, y oMLX ofrece descargar el borrador incoai/Qwen3.8-Flash-Next-DFlash2[5] si falta (PR #4719).
Las notas afirman que Splash 1.4.0 lee expertos desde el SSD cuando falta memoria y que el GGUF Q2_0 funcionó en un M5 Pro de 64 GB. También hay dos arreglos de descarga:
- Los GGUF divididos en partes, en la raíz del repositorio o en carpetas como
Q2_0/, se descargan, se listan y se borran como un solo modelo, junto con su proyector de visión - Los checkpoints OptiQ de mlx-community que guardan los pesos de visión en una subcarpeta se preparan como Splash los espera y arrancan sin el error 409
Otros arreglos de la 0.7.2
El resto de la versión son correcciones acotadas. Las que más te pueden afectar son estas:
- SpecPrefill: una petición con SpecPrefill ya no desplaza las posiciones RoPE de las peticiones que se decodifican a la vez, y los modelos de ventana deslizante dejan de procesar dos veces el último token del prompt
- DFlash: los modelos ParoQuant de Qwen3, Qwen3-MoE y Qwen3.5 pueden usarlo como objetivo
- API:
omlx launchacepta un host IPv6, y la API rechaza valores cero o negativos en máximo de tokens,top_nde rerank,dimensionsde embeddings y parámetros de muestreo de TTS - Adjuntos: los archivos que el navegador envía como
application/octet-streamse convierten según su extensión - Benchmarks: las filas tg de rendimiento decodifican la longitud completa en vez de pararse en el fin de turno del modelo
- Homebrew: las actualizaciones de la fórmula ya no se pisan cuando salen dos versiones seguidas
He comprobado el cambio de la API en mi Mac con la 0.7.2. Una petición a /v1/chat/completions con max_tokens a 0 o a -5 devuelve HTTP 422 con el mensaje "Input should be greater than 0". Si algún cliente tuyo enviaba 0 para decir "sin límite", ahora falla.
Cómo actualizar oMLX a la 0.7.2 según cómo lo instalaste
El método depende de cómo instalaste oMLX, y en los tres casos conviene comprobar la versión al terminar. La 0.7.2 pide macOS 15 Sequoia o posterior, Python 3.11 a 3.13 y un Mac con Apple Silicon, según el README de oMLX[6].
App de macOS (DMG)
La app trae actualización integrada: ábrela desde la barra de menús y acepta la actualización cuando la ofrezca. Si prefieres descargarla a mano, la página de la versión tiene dos imágenes: oMLX-0.7.2-macos26-27.dmg (875 MB) para macOS 26 y 27, y oMLX-0.7.2-macos15-sequoia.dmg (838 MB) para macOS 15. Arrastra la app a Aplicaciones y sustituye la anterior. La descarga para macOS 26 y 27 llevaba 2947 descargas a las 17:40, frente a 155 de la de Sequoia.
Homebrew
La fórmula del repositorio apunta a la 0.7.2 desde las 11:07 del mismo día. Actualiza el índice, después el paquete, y reinicia el servicio:
brew update
brew upgrade omlx
omlx restart
omlx --version
omlx restart delega en brew services en una instalación de Homebrew, y omlx --version debe imprimir 0.7.2. Si instalaste con --with-custom-kernel, Homebrew conserva esa opción al actualizar, así que vuelve a compilar los kernels nativos y necesita Xcode completo. El resto del ciclo (instalar, desinstalar, logs) está en la guía de Homebrew para oMLX.
Desde el código fuente
En una instalación desde el repositorio, trae la etiqueta nueva y vuelve a compilar los kernels, porque el kernel de atención dispersa cambió en el PR #4722:
cd omlx
git fetch --tags
git checkout v0.7.2
make install
make install reinstala el servidor y la interfaz web y compila los kernels nativos. Si no tienes Xcode completo, usa make install-no-kernels; si solo quieres recompilar los kernels, make kernels.
La página de la versión publica también paquetes wheel de Python (omlx-0.7.2-cp311, cp312 y cp313, para macOS 15 universal2), pero el README no documenta instalar desde ellas. Tampoco hay paquete omlx en PyPI: su API respondía 404 a las 17:45.
Qué revisar antes de actualizar
Las notas de la 0.7.2 avisan de cuatro cambios de comportamiento:
- Memoria de DeepSeek V4.1: el prefill en bloques de 8192 tokens sube el pico entre 4 y 7 GB con un prompt de 16K. Con la caché en SSD, los bloques también son de 8192 tokens, y un cambio dentro de los últimos 8192 tokens recalcula desde ese límite
- Clústeres: Lightning MTP se activa en los despliegues cuyo checkpoint trae cabeza de borrador. Desactívalo en los ajustes del modelo si quieres el comportamiento anterior
- Benchmarks: las filas tg decodifican la longitud completa, así que los tok/s de generación no se comparan con ejecuciones anteriores de modelos que paraban antes
- Instalaciones desde código: hay que ejecutar
make installomake kernelstras actualizar
Si saltas desde la 0.7.0, lee también las notas de la 0.7.1rc1[7]. oMLX pasó a MLX 0.32.4 y eliminó unas 150 variables de depuración OMLX_*.
La app dejó de enlazar omlx en /opt/homebrew/bin, y los modelos sin muestreo guardado toman ahora los valores de su generation_config.json. Cuando pasé mi Mac de la 0.6.4 a la serie 0.7, MTP quedó desactivado sin aviso en los modelos -mtp y tuve que volver a activarlo a mano. Revisa ese ajuste después de actualizar.
Problemas conocidos de la 0.7.2
A las 17:45 del día de publicación no había ninguna incidencia abierta que señalara un fallo nuevo de la 0.7.2. Las abiertas que la rodean son estas:
- Rendimiento menor tras la 0.7.1 (incidencia #4735[8]): un usuario de M5 Max con Qwen3.8-27B-MTPLX baja de más de 30 a 9 tokens por segundo. El mantenedor probó la 0.7.1rc1, la 0.7.1 y la 0.7.2 en un M5 Max de 128 GB con el mismo checkpoint y no lo reprodujo
- DeepSeek V4.1 en dos M5 Ultra (incidencia #4720): el atasco de 1 token por segundo es el que corrige la 0.7.2, y el mantenedor ha pedido que se repita la prueba
- Trabajadores CUDA en el clúster (incidencias #4739 a #4743): cinco informes sobre un Mac coordinando un DGX Spark, abiertos el mismo 21 de octubre pero escritos con la 0.7.1. Si usas un nodo NVIDIA, espera antes de actualizar el clúster
Preguntas frecuentes
¿Merece la pena actualizar a oMLX 0.7.2 si ya tengo la 0.7.1?
Sí, si usas Claude Code, DeepSeek V4.1 o un clúster de dos o más Mac: son los tres casos con cambios medibles. Con un solo Mac y modelos Qwen o Gemma en MLX, la ganancia son correcciones de API e interfaz, y puedes esperar a la siguiente versión.
¿La 0.7.2 cambia mis ajustes o mis modelos descargados?
Las notas no mencionan migraciones de ajustes ni de modelos. El único cambio de comportamiento por defecto es Lightning MTP en clústeres. Si saltas desde la 0.7.0, los cambios de la 0.7.1rc1 sí afectan a variables de entorno, ajustes de DFlash y valores de muestreo.
¿Puedo instalar oMLX 0.7.2 con pip?
No hay paquete omlx en PyPI. La página de la versión publica paquetes wheel para Python 3.11, 3.12 y 3.13, pero los métodos documentados son la app, Homebrew y make install desde el código.
Conclusión
oMLX 0.7.2 no es una versión de mantenimiento para quien usa Claude Code con modelos locales: el arreglo del prefill repetido cambia cuánto esperas en cada turno. Para DeepSeek V4.1 y los clústeres de dos o más Mac, las cifras del mantenedor muestran ganancias de entre un 13 y un 102 %, que no he medido en mi equipo. Actualiza con el método con el que instalaste, comprueba omlx --version y revisa la memoria si ejecutas DeepSeek V4.1 con prompts largos.
Los benchmarks y el ajuste fino en un M5 Max están en la guía de cómo instalar oMLX en un M5 Max de 128 GB. El otro cambio de la semana para modelos locales en Mac es Ollama 0.40 con MLX por defecto.
Fuentes: [1] Notas de la versión 0.7.2 de oMLX[2], [2] Notas de la versión 0.7.1 de oMLX[9], [3] Notas de la versión 0.7.1rc1 de oMLX[7], [4] Comparación de v0.7.1 y v0.7.2[1], [5] README de oMLX, instalación[6], [6] Incidencia #4720 sobre DeepSeek V4.1 en clúster[4], [7] Incidencia #4735 sobre velocidad de generación[8], [8] DeepSeek-V4.1-Flash-1017 en Hugging Face[3], [9] Borrador incoai/Qwen3.8-Flash-Next-DFlash2[5], [10] Manual de Homebrew[10], [11] Web de oMLX[11].
Fuentes
Código fuente
Accede a todo el código fuente de este artículo en GitHub.
Ver en GitHub