Cómo generar voz con modelos TTS de oMLX en tu Mac
Índice de contenidos
- Puntos clave
- Qué modelos de voz sirve oMLX y cuál elegir
- Cómo descargar un modelo de voz en oMLX
- Cómo pedir audio a /v1/audio/speech
- Voces predefinidas, voces descritas y clonación
- Voz predefinida con Kokoro o Qwen3-TTS CustomVoice
- Voz descrita con instrucciones
- Clonación a partir de una referencia
- Cómo transcribir con parakeet para obtener ref_text y comprobar cada clip
- Cómo oír el primer audio antes de que termine la generación
- Cuánto tarda y cómo suena: lo que medí en un M5 Max
- Qué puedes hacer con voz generada en tu propio Mac
- Dificultades con las que me he topado
- Consentimiento, ley y licencias antes de clonar una voz
- Preguntas frecuentes
- ¿Qué modelo TTS de oMLX conviene para español?
- ¿Necesito internet para generar voz con oMLX?
- ¿Puedo usar el cliente de OpenAI con oMLX para generar voz?
- Conclusión
- Fuentes
oMLX no solo sirve modelos de lenguaje: también genera voz en tu Mac con la misma API de texto a voz (TTS) que OpenAI. oMLX es un servidor de modelos para Mac con Apple Silicon construido sobre MLX; si no lo conoces, empieza por qué es oMLX y en qué se diferencia de Ollama y LM Studio. En esta guía descargas un modelo de voz, pides audio con una voz predefinida, con una voz descrita en texto o con una voz clonada, compruebas cada clip con una transcripción automática y ves qué tiempos y qué calidad medí en un M5 Max de 128 GB con oMLX 0.7.2. También repaso lo que no conviene hacer, empezando por clonar voces sin permiso. Hay versión en inglés.
Puntos clave
- oMLX 0.7.2 expone
POST /v1/audio/speech(texto a voz),POST /v1/audio/transcriptions(voz a texto) yGET /v1/audio/voices, compatibles con el cliente oficial de OpenAI. - Hay tres formas de elegir voz: una voz predefinida (
voice), una voz descrita en lenguaje natural (instructions) o una clonación conref_audioen base64 másref_text, que oMLX exige siempre que mandas audio de referencia. - En mi M5 Max, Qwen3-TTS 1.7B Base y Chatterbox Multilingual v3 tardan 0,33 s por cada segundo de audio; con
stream: trueel primer fragmento llega a los 0,14 s. - Una transcripción con parakeet-tdt-0.6b-v3 te da el
ref_textde la referencia y detecta clips mal leídos, siempre que compares contra el texto escrito y no contra el texto respelado. - Clona solo voces con consentimiento expreso: en España, usar la voz de alguien con fines comerciales sin permiso es una intromisión ilegítima según la Ley Orgánica 1/1982.
Qué modelos de voz sirve oMLX y cuál elegir
oMLX reconoce un modelo de voz por su configuración y lo sirve con mlx-audio, la biblioteca de audio para MLX. La 0.7.2 fija mlx-audio en la versión 0.5.7, según el pyproject.toml de oMLX 0.7.2[1]. Esa versión trae 41 carpetas de modelos de texto a voz en el repositorio de mlx-audio[2]. En la práctica he probado seis modelos de voz y uno de transcripción:
| Modelo | Qué hace | Idiomas | Licencia |
|---|---|---|---|
| Qwen3-TTS 1.7B Base | Clona una voz desde audio de referencia | 10, español incluido | Apache-2.0 |
| Qwen3-TTS 1.7B CustomVoice | 9 voces predefinidas con control por instrucciones | 10 | Apache-2.0 |
| Qwen3-TTS 1.7B VoiceDesign | Crea una voz a partir de una descripción | 10 | Apache-2.0 |
| Chatterbox Multilingual v3 | Clona una voz, también entre idiomas | 23 | MIT |
| VoxCPM2 | Diseña o clona voces y genera audio a 48 kHz | 30 | Apache-2.0 |
| Kokoro-82M | Voces predefinidas, tres en español | 8 | Apache-2.0 |
| parakeet-tdt-0.6b-v3 | Transcribe voz a texto | 25 de Europa | CC-BY-4.0 |
Las licencias salen de las fichas de cada modelo en Hugging Face: Qwen3-TTS[3], Chatterbox[4], VoxCPM2[5], Kokoro-82M[6] y parakeet-tdt-0.6b-v3[7]. Si buscas una sola recomendación para español, empieza por Qwen3-TTS 1.7B Base: clona bien, admite streaming y respeta el idioma que le pides.
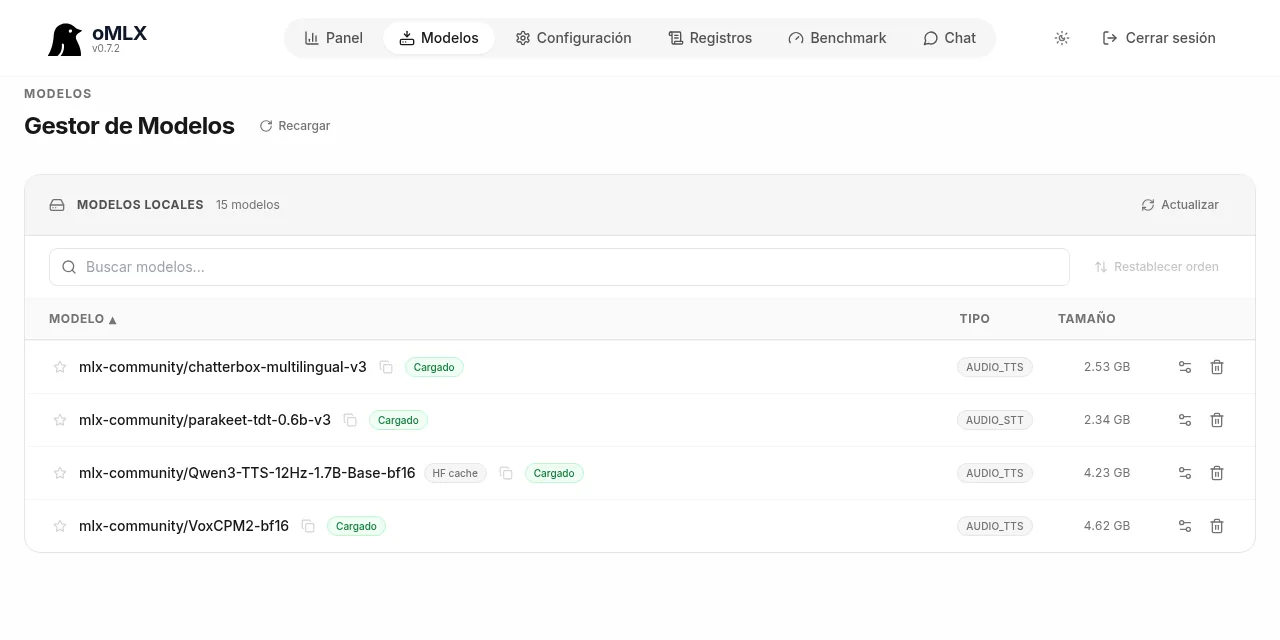
En disco, según el gestor de modelos de oMLX en mi Mac, ocupan esto:
- Chatterbox Multilingual v3: 2,53 GB
- parakeet-tdt-0.6b-v3: 2,34 GB
- Qwen3-TTS 1.7B Base en bf16: 4,23 GB
- VoxCPM2 en bf16: 4,62 GB
Cómo descargar un modelo de voz en oMLX
La vía directa es el propio panel: abre http://localhost:8000/admin, entra en Modelos, pestaña Descargas, busca Qwen3-TTS o chatterbox y elige la conversión MLX de mlx-community. Cuando termina, el Gestor lo muestra con el tipo AUDIO_TTS. Si alguna conversión no se detecta bien, los ajustes del modelo tienen un selector Model type con las opciones Audio STT, Audio TTS y Audio STS.
Si prefieres la terminal, descarga con la herramienta de línea de comandos de Hugging Face dentro del directorio de modelos de oMLX, que por defecto es ~/.omlx/models:
hf download mlx-community/Qwen3-TTS-12Hz-1.7B-Base-bf16 \
  --local-dir ~/.omlx/models/mlx-community/Qwen3-TTS-12Hz-1.7B-Base-bf16
Después pulsa Recargar en el gestor de modelos. El identificador que usarás en la API es el que devuelve GET /v1/models; en mi Mac, el modelo de Qwen descargado desde la caché de Hugging Face aparece como mlx-community--Qwen3-TTS-12Hz-1.7B-Base-bf16. La app DMG y la instalación con Homebrew ya incluyen mlx-audio; desde el código fuente necesitas el extra audio. Si el puerto o la clave de la API no son los de por defecto, revisa cómo configurar la clave, el puerto y los endpoints de oMLX.
Cómo pedir audio a /v1/audio/speech
El endpoint recibe un JSON con dos campos obligatorios, model e input, y devuelve el audio en el cuerpo de la respuesta. Estos son los campos que acepta la 0.7.2, según su esquema OpenAPI y el código de las rutas de audio[8]:
model: identificador del modelo de vozinput: el texto que se va a leer; oMLX rechaza un texto vacíovoice: nombre de una voz predefinida; si el modelo no tiene voces con nombre, oMLX lo pasa como descripción o lo descartalanguage: código de idioma, comoes; solo llega a los modelos que lo aceptaninstructions: descripción de la voz o del tono en lenguaje naturalspeed: multiplicador de velocidad, 1,0 por defectoresponse_format:wav(por defecto),mp3,opus,flacopcmref_audioyref_text: audio de referencia en base64 y su transcripción, para clonartemperature,top_k,top_p,repetition_penaltyymax_tokens: muestreo; la 0.7.2 rechaza valores cero o negativosstreamystreaming_interval: envío del audio por fragmentos, solo en WAV
El mapeo depende del modelo, y ahí está la primera sorpresa. oMLX solo entrega language a los modelos cuya función de generación tiene el parámetro lang_code: Qwen3-TTS, Chatterbox y Kokoro lo tienen, VoxCPM2 no, así que con VoxCPM2 el idioma que mandas se pierde. Chatterbox, en cambio, usa inglés por defecto si no le dices nada.
La petición mínima con curl lista los modelos y, para uno con voces predefinidas, sus nombres:
curl -s http://localhost:8000/v1/models \
  -H "Authorization: Bearer tu_clave_de_api"
curl -s "http://localhost:8000/v1/audio/voices?model=Kokoro-82M-bf16" \
  -H "Authorization: Bearer tu_clave_de_api"
/v1/audio/voices lee los metadatos sin cargar el modelo. Con Kokoro devuelve sus voces, y en español son ef_dora, em_alex y em_santa. Con los modelos de clonación devuelve una lista vacía, porque no tienen voces con nombre.
Voces predefinidas, voces descritas y clonación
Elegir el modo es lo primero, porque cada modelo admite uno o dos de los tres. Las voces predefinidas son las más previsibles, las descritas sirven para crear un personaje sin grabar a nadie y la clonación reproduce una voz concreta a partir de una muestra.
Voz predefinida con Kokoro o Qwen3-TTS CustomVoice
Con una voz predefinida, manda solo voice. En Kokoro, oMLX deduce el idioma de la primera letra del nombre (e es español), así que ef_dora lee en español aunque no mandes language. Qwen3-TTS CustomVoice trae 9 voces, entre ellas Ryan y Aiden, y acepta además instructions para cambiar el tono. Un aviso para quien escribe en castellano: ninguna de estas voces es de España, y lo noto en el acento (lo cuento en las dificultades).
Voz descrita con instrucciones
Con VoxCPM2 o Qwen3-TTS VoiceDesign describes la voz en instructions y el modelo la inventa. Así generé la referencia sintética de esta guía, sin grabar a ninguna persona:
curl -s http://localhost:8000/v1/audio/speech \
  -H "Authorization: Bearer tu_clave_de_api" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "VoxCPM2-bf16",
    "input": "Hola, soy una voz sintética diseñada con una descripción.",
    "instructions": "A calm adult woman from Madrid, documentary narrator"
  }' -o referencia.wav
La descripción va en inglés porque VoxCPM2 y Qwen3-TTS siguen peor las instrucciones en español. El clip de 7,5 s salió en 5,2 s, con la carga del modelo incluida, a 48 kHz. Este es el resultado, reducido a MP3:
Clonación a partir de una referencia
Para clonar mandas el audio de referencia en base64 en ref_audio y su transcripción exacta en ref_text. oMLX responde con un error 400 si mandas ref_audio sin ref_text, aunque el modelo concreto no lo use, y admite hasta 20 MB de base64, unos 60 s de audio. Con el cliente oficial de OpenAI para Python, los campos que no son de OpenAI van en extra_body:
import base64
from pathlib import Path
from openai import OpenAI

client = OpenAI(base_url="http://localhost:8000/v1",
                api_key="tu_clave_de_api")
ref = base64.b64encode(Path("referencia.wav").read_bytes()).decode()

with client.audio.speech.with_streaming_response.create(
    model="mlx-community--Qwen3-TTS-12Hz-1.7B-Base-bf16",
    voice="alloy",
    input="Con oMLX, tu Mac genera esta narración en local.",
    response_format="mp3",
    extra_body={"language": "es", "ref_audio": ref,
                "ref_text": Path("referencia.txt").read_text()},
) as respuesta:
    respuesta.stream_to_file("narracion.mp3")
El SDK exige voice, pero oMLX no lo reenvía a Qwen3-TTS Base porque ese modelo no tiene voces con nombre. Lo probé con la versión 3.36.0 del paquete openai, y la petición tardó 1,18 s. El clip siguiente es Qwen3-TTS 1.7B Base clonando la voz sintética anterior: 11,7 s de audio generados en 3,09 s.
Con este mismo esquema puedes encadenar dos modelos, como recomienda la ficha de Qwen3-TTS. Diseñas una voz una vez y la clonas en cada clip, así el personaje suena igual en todo un vídeo.
Cómo transcribir con parakeet para obtener ref_text y comprobar cada clip
POST /v1/audio/transcriptions cumple dos funciones en este flujo: escribe el ref_text de tu referencia y comprueba que cada clip generado dice lo que escribiste. Recibe el audio como formulario multiparte:
curl -s http://localhost:8000/v1/audio/transcriptions \
  -H "Authorization: Bearer tu_clave_de_api" \
  -F model=parakeet-tdt-0.6b-v3 -F language=es \
  -F file=@referencia.wav
Con la referencia sintética, parakeet devolvió las 22 palabras exactas en 0,37 s. Para la comprobación automática uso la tasa de error por palabra (WER), el porcentaje de palabras sustituidas, omitidas o añadidas respecto al texto original. Esta función la calcula sin dependencias:
import re
import unicodedata

def palabras(texto):
    t = unicodedata.normalize("NFD", texto.lower())
    t = "".join(c for c in t if unicodedata.category(c) != "Mn")
    return re.sub(r"[^\w\s]", " ", t).split()

def wer(escrito, oido):
    a, b = palabras(escrito), palabras(oido)
    d = list(range(len(b) + 1))
    for i, x in enumerate(a, 1):
        prev, d[0] = d[0], i
        for j, y in enumerate(b, 1):
            prev, d[j] = d[j], min(d[j] + 1, d[j - 1] + 1, prev + (x != y))
    return 100 * d[-1] / len(a)
Transcribe cada clip con client.audio.transcriptions.create(model="parakeet-tdt-0.6b-v3", file=…, language="es") y revisa a mano los que pasen de un umbral, por ejemplo un 5 %. Compara siempre contra el texto escrito, con sus cifras, y no contra la versión respelada que le pasas al modelo: parakeet vuelve a escribir los números en cifras. Con un texto respelado, una comparación ingenua marcó un clip correcto con un 45,8 % de error.
Cómo oír el primer audio antes de que termine la generación
Con "stream": true oMLX empieza a mandar audio WAV en cuanto el modelo produce el primer fragmento. Qwen3-TTS y Chatterbox lo hacen de forma nativa, cada 0,2 s por defecto (streaming_interval). Con los demás modelos, oMLX trocea el texto en frases de hasta 300 caracteres y manda cada una al terminarla.
La diferencia se nota. Para el mismo clip de 11,7 s con la voz clonada, la respuesta completa tardó 3,09 s, mientras que en streaming los primeros bytes llegaron a los 0,14 s. Con el SDK de OpenAI, añade "stream": True a extra_body y recorre respuesta.iter_bytes(); así medí 0,18 s hasta el primer fragmento. Solo funciona con response_format en wav; con otro formato oMLX devuelve un error 400.
Cuánto tarda y cómo suena: lo que medí en un M5 Max
En un M5 Max de 128 GB, los modelos de voz servidos por oMLX generan audio entre 1,4 y 3 veces más rápido que el tiempo real. Lo comparé con la CPU del mismo Mac, desde un contenedor Linux con PyTorch, donde los mismos modelos tardan de 17 a 21 s por cada segundo de audio. La medida es el factor de tiempo real (RTF): segundos de cálculo por segundo de audio, con el modelo ya cargado.
Para la calidad cloné en español una grabación de referencia de 26 s, hecha con el permiso de su dueño y que no publico, con tres textos distintos. Transcribí cada clip con parakeet para calcular el WER y comparé el timbre con un modelo de verificación de locutor (ECAPA de SpeechBrain). Como referencia, la propia grabación real da un WER de 1,8 % y una similitud de 0,904 entre sus dos mitades.
Chatterbox y Qwen3-TTS empatan en la práctica: 10,4 % frente a 11,0 % de errores y la misma similitud de timbre. VoxCPM2 queda algo por detrás y, además, 3 de sus 12 clips arrancaron en inglés. MOSS-TTS no produjo voz utilizable a través de oMLX.
Para producir narraciones me quedé con Qwen3-TTS 1.7B Base. Clona igual de bien que Chatterbox, tiene streaming nativo y mantiene el español en todos los clips.
Qué puedes hacer con voz generada en tu propio Mac
La ventaja de generar voz en tu propio equipo es que el texto no sale del equipo y que cada clip no cuesta nada más allá de la electricidad. Estos son los usos en los que lo he visto encajar:
- Narración de vídeos y tutoriales: una voz constante para decenas de clips, regenerables cuando cambias una frase del guion
- Accesibilidad y lectura en voz alta: versiones de audio de artículos o de documentación interna para quien prefiere escuchar
- Podcasts y maquetas de audio: probar un guion con dos voces descritas antes de grabarlo con personas
- Prototipos de centralita (IVR): los mensajes de un menú telefónico, rehechos en segundos cada vez que cambia una opción
- Localización: Chatterbox Multilingual v3 clona una voz y la hace hablar en 23 idiomas, útil para doblar un vídeo propio
Los modelos de voz ocupan entre 2,5 y 4,6 GB cada uno. Si los vas a servir junto a modelos de lenguaje, revisa cómo gestiona oMLX la memoria entre modelos.
Dificultades con las que me he topado
La mayor parte de los problemas no vienen de oMLX sino del texto que le das al modelo. Estas son las dificultades con las que me he topado al pasar de pruebas sueltas a narrar vídeos completos:
- Los números se leen mal: Qwen3-TTS leyó el número 9443 como "nueve cuatro cuarenta y tres". Escribe las cifras en palabras en el texto que mandas al modelo y guarda la versión con cifras para comprobar el resultado.
- Los términos técnicos también: "host" se entendía como "lost" y npm salía mal pronunciado. Un diccionario de pronunciación que sustituye cada término por cómo suena en español lo resuelve.
- VoxCPM2 se pasa al inglés: oMLX no le entrega
language, y 3 de 12 clips en español empezaron en inglés. Con VoxCPM2, revisa cada clip. - Chatterbox sin
languagehabla en modo inglés: el mismo texto en español pasó de 0 a 3 palabras mal leídas de 30 al quitar"language": "es". - No todos los modelos funcionan: MOSS-TTS produjo audio ininteligible y el doble de largo, y Higgs Audio 3 no cargó en oMLX 0.7.1rc1 porque mlx-audio no reconoce su tipo de modelo.
ref_textes obligatorio: sin él oMLX devuelve un error 400. Transcribe la referencia con parakeet y corrige a mano lo que oiga mal.- La referencia manda: una muestra leída, limpia y de 10 a 30 s clona mejor que una cantada o con música de fondo, y el acento de la referencia pasa al clon.
- El acento de España no viene de serie: un clasificador de acentos situó la voz
ef_dorade Kokoro en el Caribe (probabilidad de España de 0,085), y las voces descritas de Qwen3-TTS nunca me salieron con acento peninsular.
Consentimiento, ley y licencias antes de clonar una voz
Clonar una voz es técnicamente trivial, pero legalmente no es neutro. En España, la Ley Orgánica 1/1982[9] considera intromisión ilegítima en su artículo 7.6 "la utilización del nombre, de la voz o de la imagen de una persona para fines publicitarios, comerciales o de naturaleza análoga". El artículo 2 la excluye solo con consentimiento expreso del titular, que además puede revocarlo en cualquier momento. Mi regla: clono únicamente voces cuyo dueño me ha dado permiso por escrito para ese uso, y nunca voces de audiolibros, entrevistas o vídeos ajenos.
Etiquetar el audio sintético es la otra mitad. El Reglamento europeo de inteligencia artificial[10] obliga en su artículo 50 a hacer público que un audio es artificial cuando constituye una ultrasuplantación. Es decir, cuando se parece a una persona real y puede hacer creer que es auténtico. Tienes el contexto en qué cambia el Reglamento de IA para tu empresa.
YouTube pide declarar el contenido realista generado con IA, incluido el que hace decir a una persona real algo que no dijo, según su política de divulgación de contenido generado con IA[11]. Clonar tu propia voz para narrar figura en su lista de usos que no requieren aviso, pero yo lo declaro igualmente en la descripción.
Revisa también la licencia del modelo antes de usarlo en un proyecto comercial. Qwen3-TTS, VoxCPM2 y Kokoro son Apache-2.0 y Chatterbox es MIT, pero estos tres modelos conocidos prohíben el uso comercial:
- F5-TTS: CC-BY-NC-4.0[12]
- Fish Speech 1.5: CC-BY-NC-SA-4.0[13]
- Voxtral 4B TTS: CC-BY-NC-4.0[14]
El paquete original de Chatterbox añade una marca de agua inaudible a su salida; no he comprobado si la conversión a MLX que sirve oMLX la conserva.
Preguntas frecuentes
¿Qué modelo TTS de oMLX conviene para español?
Qwen3-TTS 1.7B Base para clonar una voz con permiso, con un 11,0 % de errores por palabra y streaming nativo en mis pruebas. Chatterbox Multilingual v3 da una calidad equivalente y cubre 23 idiomas, pero exige mandar language en cada petición.
¿Necesito internet para generar voz con oMLX?
Solo para descargar el modelo la primera vez. Después, el texto, la referencia y el audio generado se quedan en tu Mac, y oMLX responde en localhost sin llamar a ningún servicio externo.
¿Puedo usar el cliente de OpenAI con oMLX para generar voz?
Sí. Apunta base_url a http://localhost:8000/v1 y llama a client.audio.speech.create. Los campos propios de oMLX, como language, ref_audio, ref_text o stream, van en extra_body.
Conclusión
oMLX convierte un Mac con Apple Silicon en un servidor de voz con la API que ya conoces de OpenAI. En un M5 Max genera audio entre 1,4 y 3 veces más rápido que el tiempo real. Empieza por Qwen3-TTS 1.7B Base, comprueba cada clip con parakeet contra el texto escrito, respela números y términos técnicos y no clones ninguna voz sin un permiso por escrito. Si todavía no tienes oMLX, la guía de cómo instalar y ajustar oMLX en un M5 Max te deja el servidor listo.
Fuentes: [1] README de oMLX[15], [2] Rutas de audio de oMLX 0.7.2[8], [3] Dependencias de oMLX 0.7.2[1], [4] Repositorio de mlx-audio[2], [5] Ficha de Qwen3-TTS 1.7B CustomVoice[3], [6] Ficha de Chatterbox de Resemble AI[4], [7] Ficha de VoxCPM2[5], [8] Ficha de Kokoro-82M[6], [9] Ficha de parakeet-tdt-0.6b-v3[7], [10] Ley Orgánica 1/1982 en el BOE[9], [11] Reglamento (UE) 2024/1689 en el BOE[10], [12] Política de YouTube sobre contenido generado con IA[11], [13] Ficha de F5-TTS[12], [14] Ficha de Fish Speech 1.5[13], [15] Ficha de Voxtral 4B TTS[14].
Fuentes
- pyproject.toml de oMLX 0.7.2
- repositorio de mlx-audio
- Qwen3-TTS
- Chatterbox
- VoxCPM2
- Kokoro-82M
- parakeet-tdt-0.6b-v3
- esquema OpenAPI y el código de las rutas de audio
- Ley Orgánica 1/1982
- Reglamento europeo de inteligencia artificial
- política de divulgación de contenido generado con IA
- CC-BY-NC-4.0
- CC-BY-NC-SA-4.0
- CC-BY-NC-4.0
- README de oMLX
Código fuente
Accede a todo el código fuente de este artículo en GitHub.
Ver en GitHub