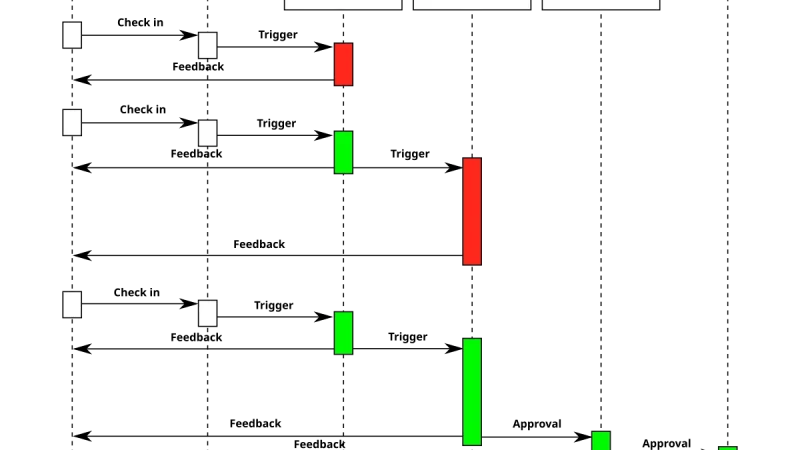
Los agentes de IA empiezan a tener un hueco serio en los pipelines de integración continua: revisar diffs, proponer arreglos, generar tests que faltan. Seis meses de uso real para separar los patrones que funcionan de los que acaban costando más tiempo del que ahorran.
Google publicó Gemini 2.5 Pro en vista previa en marzo y la versión general llegó en junio. El salto respecto a Gemini 2.0 no está solo en puntuaciones sino en dos frentes prácticos: ventana de contexto utilizable en serio y multimodalidad que deja de ser demostración para convertirse en herramienta.
Anthropic presentó Claude Opus 4 y Claude Sonnet 4 el 22 de mayo de 2025, el primer salto grande de nomenclatura desde la serie 3.5. Un mes de uso real en código, documentación técnica y agentes para separar lo que ha mejorado de lo que sigue igual.
Un año después de que la interfaz de chat dejara de ser la única forma aceptable de hablar con un agente, aparecen patrones de UI pensados específicamente para tareas de agente. Repaso los que empiezan a cuajar y los que solo son moda de ciclo.
Revisión de septiembre de 2026 de los servidores MCP que uso a diario: filesystem, git, fetch y memory siguen siendo de referencia, y DBHub sustituye al servidor de Postgres archivado. El registro oficial verifica quién publica, no la seguridad del código, así que aplico cinco criterios y listo las herramientas con el MCP Inspector antes de conectar nada.
Prompt injection es la vulnerabilidad más común en aplicaciones con LLM y mucha gente la defiende con filtros que no sirven. Revisamos capas de defensa con evidencia, qué sí funciona y qué es teatro de seguridad.
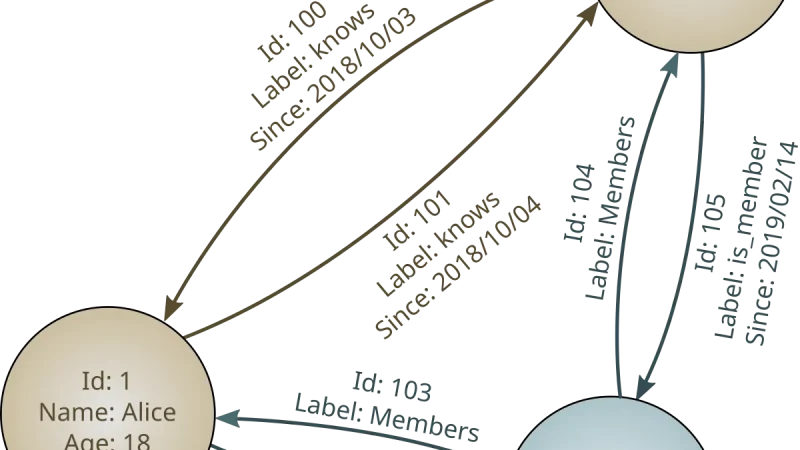
Durante una década, los grafos de conocimiento fueron una idea académica con pocos casos de uso reales, frenada por el coste de construir y mantener el esquema. Los LLM han cambiado esa ecuación: ahora extraen entidades automáticamente y sirven para anclar respuestas, auditar razonamiento y sostener agentes sin alucinar.
En sistemas de IA el coste real no está en las instancias EC2, sino en los tokens de entrada de RAG y agentes, las llamadas de herramientas encadenadas y los reindexados frecuentes; esos vectores, sumados a los experimentos sin atribución, concentran la mayor parte de la factura mensual en producción.
Un sistema RAG sin evaluación continua se degrada en silencio. Los índices cambian, los modelos se actualizan, los usuarios preguntan cosas nuevas. Este es un repaso práctico de qué métricas vigilar y cómo montar el cuadro de mando que avisa antes del incidente.
Los datos de Crunchbase y CB Insights del primer trimestre confirman que la financiación global ha repuntado, pero casi todo el crecimiento está concentrado en startups que se presentan como IA. El resto del ecosistema sigue en corrección.
La mitad del ecosistema IA de 2024 era una capa fina sobre la API de OpenAI. Dos años después, unos cuantos se han convertido en producto y el resto ha desaparecido. Revisión de qué separa un wrapper serio de un agujero por donde se va el dinero.
Cuando un LLM pasa de contestar texto a ejecutar herramientas, la superficie de ataque cambia de categoría. La inyección de prompts, la contaminación de memoria y el abuso de protocolos entre agentes son el nuevo OWASP Top 10.
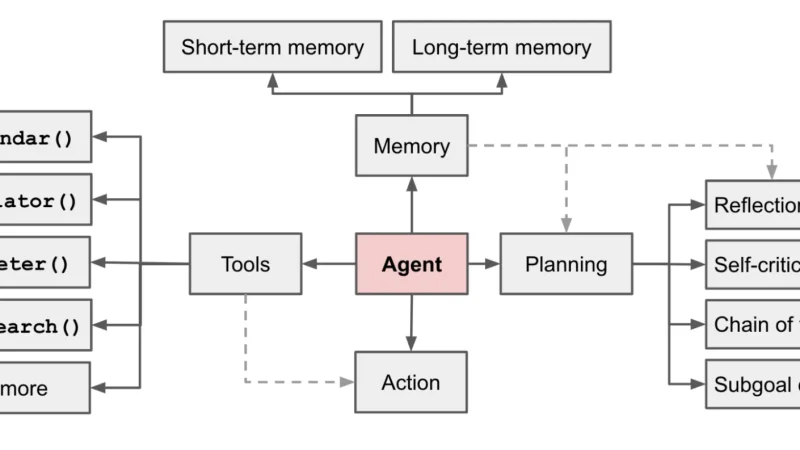
Los agentes de IA han pasado de ser un tema de laboratorio a tener SDKs serios en tres grandes proveedores. Reflexión sobre cómo pasar de la demo llamativa a un caso de uso interno que mueva una métrica real.
Desde que Microsoft abrió GraphRAG, el patrón de usar grafos sobre tus propios datos ha pasado de experimento académico a técnica con aplicaciones prácticas. Reflexión sobre cuándo compensa, cómo se monta y qué errores se repiten.
Las funciones de IA que Figma ha ido integrando desde Config 2024 están cambiando cómo trabajan los equipos de diseño de producto. Repaso de qué aporta cada función, qué se mantiene como trabajo humano y qué hábitos están cuajando.
Con las primeras obligaciones del AI Act europeo ya en vigor, la gobernanza de la IA en empresa deja de ser teórica. Qué comités montar, qué políticas escribir y qué auditar, desde la experiencia de varias implantaciones.
Anthropic publicó Claude 3.7 Sonnet a finales de febrero con pensamiento extendido opcional y un compañero de consola llamado Claude Code. Reflexión sobre qué cambia de verdad y qué queda para la próxima familia.
Hace un año los pesos abiertos eran una apuesta; hoy son una opción de producción real. Repaso lo que ha funcionado, lo que no y cómo están encajando Llama, DeepSeek, Qwen y Mistral en arquitecturas empresariales que antes dependían de APIs cerradas.
vLLM sigue siendo el motor de referencia para servir LLM en GPU en 2025: el prefix caching automático recorta drásticamente la latencia con prompts repetidos, el speculative decoding acelera los modelos grandes y el soporte multi-LoRA abarata el SaaS multi-tenant, aunque el multi-GPU y el hardware no NVIDIA siguen siendo puntos débiles.
GraphRAG lleva más de un año en uso empresarial real: durante la indexación, un LLM construye un grafo de conocimiento que responde bien a preguntas globales sobre un corpus, justo donde el RAG clásico falla porque ningún fragmento aislado contiene la respuesta completa. Aquí comparo costes de indexación, casos donde compensa y el patrón híbrido que se ha impuesto entre equipos.
Tres años después de que RLHF se hiciera popular, el paisaje del alineamiento de modelos es más rico. Repaso de RLHF, DPO y los métodos más recientes como KTO o ORPO, con criterios para elegir.
Google publicó Gemma 2 a mediados de 2024 y ya lleva tiempo en uso real. Balance de cómo compite en el ecosistema de modelos abiertos, qué tamaños tienen sentido y dónde ha cuajado su adopción.
Google ha lanzado Gemini 2.0 con un énfasis claro en uso de herramientas y agentes. Repaso de qué aporta, dónde está por detrás de la competencia y en qué tipo de aplicaciones encaja mejor.
Dos años probando revisiones de código asistidas por IA en un equipo real dejan un balance claro: la IA detecta bien olvidos mecánicos y genera resúmenes útiles de cada pull request, pero falla en juicio arquitectónico y comete muchos falsos positivos en bugs sutiles. La decisión que más ha ayudado ha sido no bloquear el merge por sus comentarios automáticos.
Meta publicó Llama 3.2 con modelos de 1B y 3B parámetros cuantizados a 4 bits para ejecutarse en dispositivos con recursos limitados. El 3B ocupa 2 GB y alcanza 30-60 tokens por segundo en un portátil con M2. No compite con GPT-4: cubre clasificación, extracción estructurada y conversación guiada sin depender de APIs externas.
Los procesadores Copilot+ de Qualcomm, Intel y AMD han normalizado la presencia de una NPU en el PC doméstico. Una NPU de 40 TOPS puede ejecutar Phi-3 Mini cuantizado consumiendo entre 5 y 10 W, frente a los 40-50 W de una GPU de portátil haciendo la misma tarea. Qué cambia realmente para ejecutar modelos localmente y cuándo merece la pena.
Medir la calidad de un sistema RAG con rigor exige más que revisar unas cuantas respuestas: hacen falta métricas objetivas (fidelidad, relevancia, precisión y cobertura de contexto), un conjunto dorado de cientos de preguntas curadas y validación humana periódica del juez LLM para evitar conclusiones engañosas.
OpenAI lanzó o1-preview el 12 de septiembre de 2024: el primer modelo que razona internamente antes de responder. En lugar de generar tokens directamente, o1 dedica una fase de pensamiento oculto a explorar el problema, alcanzando un 83% en AIME frente al 13% de GPT-4o. El coste adicional se justifica en problemas complejos; para tareas cotidianas, GPT-4o sigue siendo más eficiente.
La búsqueda híbrida combina BM25 y recuperación vectorial para cubrir lo que cada una no puede sola. El vector falla en identificadores exactos como SKUs o CVEs; BM25 falla cuando consulta y documento usan vocabulario distinto. La fusión mediante Reciprocal Rank Fusion (RRF) suma los dos rankings sin depender de sus escalas de puntuación.
llama.cpp es la biblioteca en C++ que impulsa a Ollama y gran parte del ecosistema de LLM locales. En 2024 sumó decodificación especulativa con aceleraciones de dos a tres veces, un servidor RPC para repartir capas entre máquinas y un formato GGUF estable. Ollama basta para el 90% de los casos; ir directo compensa con hardware poco común.
Ollama se consolidó en 2024 como el estándar para ejecutar LLMs en local. Empaqueta llama.cpp en un binario único con interfaz de línea de comandos estilo Docker y API compatible con OpenAI. Phi-3 Mini corre en 4 GB; Llama 3.1 8B Q4 necesita 6 GB. Para tráfico de producción a escala, vLLM sigue siendo la opción correcta.
Model Context Protocol (MCP) es el estándar abierto que Anthropic publicó el 25 de noviembre de 2024 para conectar modelos de lenguaje con datos y herramientas externas mediante JSON-RPC 2.0. No sustituye al function calling: estandariza el lado del servidor, aspirando a ser para el contexto lo que el Language Server Protocol es para los editores de código.
El product-market fit para productos con LLM sigue dependiendo de las mismas señales clásicas: retención de cohortes, NPS y expansión de revenue. Lo que cambia son el baseline de calidad más alto, la velocidad de la competencia y los moats duraderos: datos propietarios, integración de workflow y efectos de red.
Las aplicaciones basadas en LLM necesitan tres planos de observabilidad distintos: trazas de prompt y respuesta para depurar alucinaciones, seguimiento de costes por token y por función, y evaluación de calidad de respuesta. Herramientas como Langfuse, LangSmith y Helicone cubren estos planos con instrumentación específica.
TensorRT-LLM es el motor de inferencia de NVIDIA que compila cada modelo en un binario optimizado para la GPU exacta y el tamaño de lote donde se va a servir. Usa kernels CUDA hechos a mano y cuantización FP8 nativa en H100. Frente a vLLM puede rendir entre 2 y 3 veces más en el mejor caso, a cambio de un build de 30 a 90 minutos.
LoRA entrena solo dos matrices pequeñas por capa y QLoRA lo hace sobre un modelo base en 4 bits. La cuenta de memoria de cada técnica y un ejemplo reproducible en Docker sin GPU: LoRA entrenó el 3,5 % de los parámetros de SmolLM2-135M con un pico de 2,35 GB, frente a 3,88 GB del ajuste completo.
Computer Use es la función de la API de Claude, lanzada por Anthropic el 22 de octubre de 2024, que deja al modelo mirar capturas de pantalla y mover el ratón, escribir y hacer clic dentro de un bucle que tu propio sistema ejecuta y controla. Rinde bien en apps sin API y falla con CAPTCHAs, interfaces muy dinámicas y tareas largas.
GitHub Copilot Workspace, en preview técnica desde abril de 2024, propone un desarrollo orientado a tareas: describe el problema en un issue de GitHub y la IA lee el codebase, genera un plan editable multi-fichero y lo implementa. Compite con Cursor Composer, aunque con más latencia; su ventaja es la integración nativa con PRs, issues e historial de GitHub.
Swarm es el framework experimental de OpenAI para orquestar sistemas multi-agente. Publicado en octubre de 2024 con una advertencia explícita de no usar en producción, reduce toda la coordinación a dos conceptos: agentes e handoffs. En menos de 500 líneas de Python demuestra que el enrutamiento puede emerger del propio modelo sin grafos ni planificadores externos.
vLLM sirve modelos de lenguaje con PagedAttention, batching continuo y una API compatible con OpenAI. En octubre de 2026 va por la 0.32.0, el motor V1 es el único desde la 0.11 y la caché de prefijos viene activada por defecto. Esta guía cubre el arranque con vllm serve, la cuantización por hardware, las métricas y cuándo elegir otra cosa.
Claude 3.5 Sonnet (Anthropic, junio de 2024) iguala la calidad de Claude 3 Opus al precio del tier Sonnet, con 200 k tokens de contexto y un 92 % en HumanEval. Destaca especialmente en coding y seguimiento de instrucciones largas, y fue el primer modelo en integrar la función Artifacts en Claude.ai.
Mistral Large 2, lanzado por la startup francesa Mistral AI en julio de 2024, es un modelo de 123.000 millones de parámetros con ventana de contexto de 128k tokens que rivaliza con GPT-4o y Claude 3.5 Sonnet en varios benchmarks. Su residencia de datos en la UE y su precio de 3 EUR por millón de tokens de entrada lo convierten en la alternativa europea más seria frente a los proveedores estadounidenses.
CrewAI es un framework Python que modela agentes de IA como un equipo con roles, objetivos y tareas concretas. Cada agente tiene un LLM base y herramientas propias. Los agentes se coordinan en una tripulación con procesos secuenciales o jerárquicos. Comparo el framework con LangGraph y AutoGen, y cuándo adoptar el patrón multi-agente.
La Assistants API de OpenAI ofrece threads persistentes, ejecución de código en sandbox y búsqueda documental gestionada, pero OpenAI la retira por completo el 26 de agosto de 2026 en favor de la Responses API. Analizamos cuándo compensaba frente a Chat Completions con infraestructura propia y qué hacer si tu proyecto todavía depende de ella.
La Ley de IA de la UE (Reglamento 2024/1689) entró en vigor el 1 de agosto de 2024. Clasifica los sistemas IA en cuatro niveles de riesgo con plazos escalonados: prohibiciones en febrero 2025, obligaciones GPAI en agosto 2025 y requisitos de alto riesgo en agosto 2026. Aplica a cualquier empresa que opere o venda en la UE, con sanciones que superan al GDPR.
Instalar Ollama en un Mac con Apple Silicon es tan simple como ejecutar un comando de Homebrew. Después, elige el modelo según la RAM disponible (Phi-3 con 8 GB, Llama 3.1 8B con 16 GB) y expón la API HTTP local, compatible con OpenAI, en el puerto 11434 para integrarla en tus propias aplicaciones.
GitLab Duo integra IA nativa en todo el flujo devops: autocompletado, chat, resumen de MR y explicación de vulnerabilidades. Duo Pro cuesta 19 dólares por usuario al mes sobre Premium o Ultimate, igual que GitHub Copilot Business. Compensa si tu equipo ya vive en GitLab.
Meta lanzó Llama 3.1 405B el 23 de julio de 2024: 405 000 millones de parámetros, 128k tokens de contexto y benchmarks equivalentes a GPT-4o y Claude 3.5 Sonnet. El self-hosting exige unos 220 GB de VRAM en Q4; Together.ai, Fireworks y Groq lo ofrecen por token.
7 min344
Usamos cookies propias y de terceros para analizar el tráfico del sitio. Puedes aceptarlas, rechazarlas o configurar tu elección.
Más información sobre las cookies
Preferencias de cookies
NecesariasImprescindibles para el funcionamiento del sitio. Siempre activas.
AnalíticasNos ayudan a entender cómo se usa el sitio (Google Analytics).